2026-09-21
阿里云发布 Qwen-Image-2.1 图像生成模型并开放权重
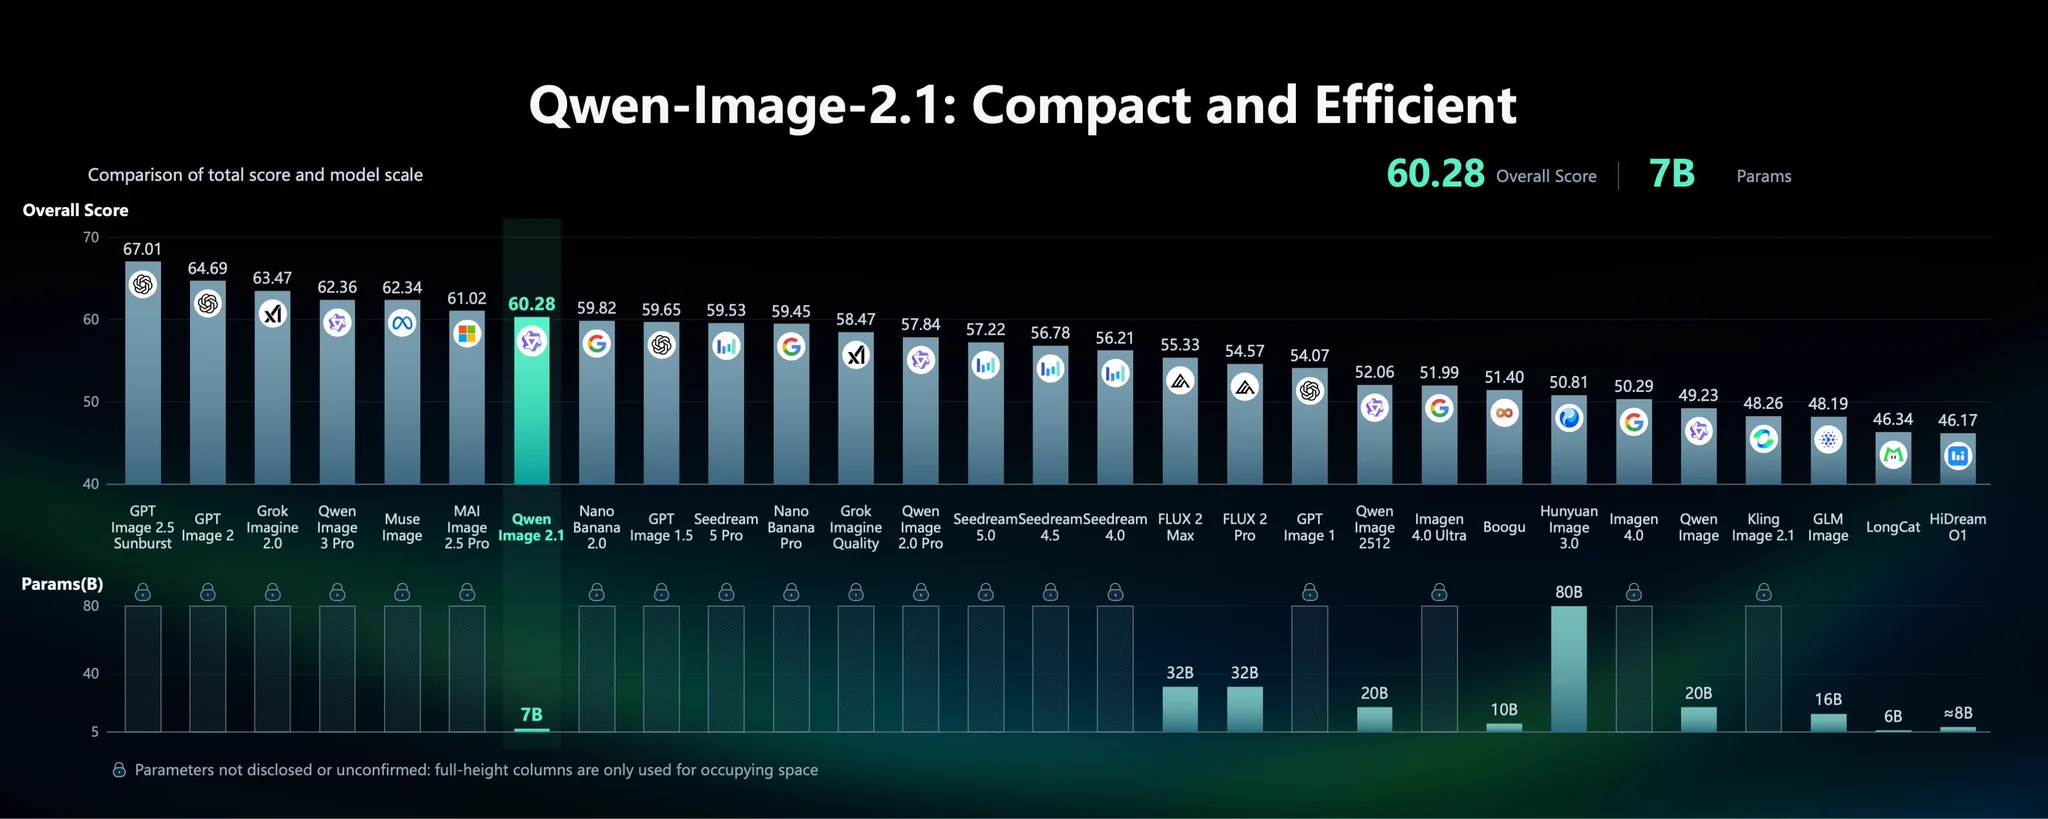
阿里云 Qwen 团队发布 Qwen-Image-2.1 图像生成模型并开放权重,定位为 Qwen-Image 系列中最均衡、高性价比的版本,统一支持生成与编辑。
阿里云 Qwen 团队发布 Qwen-Image-2.1 图像生成模型并开放权重,定位为 Qwen-Image 系列中最均衡、高性价比的版本,统一支持生成与编辑。
阿里 70 亿参数图像模型Qwen-Image-2. 1 开源发布,号称以瘦身之躯叫板闭源巨头 · 1 · Sep 21, 2026 9 阿里通义千问团队近日端出了一道让开源社区眼前一亮的菜:开放权重的图像生成与编辑模型Qwen-Image-2.1正式登场
SGLang-Diffusion 发布对 Qwen-Image 2.1 的 Day-0 支持,覆盖文本生成图像、多图编辑和透明 RGBA 输出,单 checkpoint 即可完成。
通义千问发布 Qwen-Image-2.1,一个 7B 参数的原生图像生成与编辑模型,生成和编辑共用单一检查点,最多支持 10 张参考图
通义千问开源 Qwen-Image-2.1:7B 参数实现文生图与图像编辑一体化 AIbase基地 发布于 AI新闻资讯 · 1 分钟阅读 · Sep 21, 2026 25 9月21日,通义千问团队正式开源新一代图像模型 Qwen-Image-2.1
Qwen-Image-2.1 7B 开源图像模型,支持 RGBA 透明图层生成与编辑,多图输入推理加速,适用场景覆盖真实质感与文字排版要求。
Qwen 开源 Qwen-Image-2.1:7B 统一生成与编辑并原生支持透明图像 — 点击查看完整日报
作者拆解 Qwen-Image-2.1 这个 7B 生成+编辑+透明通道三合一开源图像模型,梳理其四大能力与单流 DiT、块因果注意力、RGBA 自编码器等关键架构设计。
阿里 Qwen 团队发布开源权重图像生成与编辑模型 Qwen-Image-2.1,视觉生成部分仅 7B 参数,团队称在其自建基准上超过多数闭源模型,独立基准尚待验证,可在 RTX 3090 等消费级 GPU 上运行。
一个限时小游戏让玩家在 60 秒内判断图片是真实照片还是 AI 生成,每张图有 10 秒作答时间。游戏在计时开始前会先加载首批图片,考验用户凭直觉识别 AI 图像的能力。
Claude 没有图像生成器,这是涉及知识工作的智能体项目中的一大缺口。它很擅长用代码来绘制或建模物体,但 Google 和 OpenAI 的图像生成器为其 AI 提供了更多选项,可用于制作 PowerPoint、模型图、信息图等。
Qwen 开源 Qwen-Image-2.1,在单一模型中统一文生图与图像编辑,视觉生成组件仅 7B 参数,并原生支持透明图像的生成与编辑。模型支持最多 10 张参考图、圆圈涂画和独立掩码指定局部编辑,通过混合粒度注意力与 KV cache 复用提升推理效率,并改进了文字排版、人像光照和人物产品一致性。
剪映发布 CapCut Hub,实现 AI 视频生成与剪辑无缝衔接,PC 端提供一站式创作环境,手机端提供智能提效功能。
阿里 Qwen 团队发布并开源 Qwen-Image-2.1,一个 7B 的图像生成与编辑统一模型。官方称其推理速度大幅加快,可原生生成和编辑 RGBA 透明图层,支持最多 10 张参考图和精准局部编辑,覆盖全景图、信息图和虚拟试穿等场景。
Qwen-Image-2.1 已在 Hugging Face 上线
Qwen 宣布 Qwen-Image-2.1 现已支持 ComfyUI,权重开放。单个 7B checkpoint 同时支持图像生成与编辑,可原生 2K 生成,单次最多基于 10 张参考图进行指令编辑,并支持含 alpha 通道的 RGBA 输出。
通义千问发布 Qwen-Image-2.1,vLLM-Omni 提供 day-0 支持。该模型可在一个模型内完成图像生成、编辑和透明图像输出,由 7.1B DiT 搭配 Qwen3-VL-8B 组成,设置和受支持的组合见 https://recipes.vllm.ai/Qwen/Qwen-Image-2.1。
通义千问发布 Qwen-Image-2.1,定位为 Qwen-Image 系列中均衡且高性价比的图像生成模型,现已开放权重。该模型为生成与编辑一体化的 7B 轻量架构,原生支持生成和编辑 RGBA 透明图层,编辑支持最多 10 张参考图和精确局部控制,并擅长全景图、信息图和虚拟试穿等场景。
IT之家 9 月 20 日消息,阿里千问今日宣布,开源千问图像系列当前兼顾生成效果、推理效率与使用成本的开源图像模型 Qwen-Image-2.1。 Qwen-Image-2.1 将文生图与图像编辑整合在同一模型中,视觉生成部分仅有 7B 参数,并原生支持透明图像的生成与编辑
Runway 公布实时视频生成研究,用户可在描述提示词的同时流式生成视频,而非输入提示后等待成品。该方案基于其首个 General World Model GWM-1(构建于 Gen-4.5 之上,逐帧生成,支持镜头运动、机器人指令或音频控制),通过用自身输出训练模型来抑制误差累积。
作者评论剪映终于推出 AI 助手与创作 Hub,认为字节此前在该市场动作迟缓。
StepFun 发布旗舰级多模态 MoE 模型 Step 5 Preview,并提供多重免费试用入口,可累计获得 75 天 Plus 版本订阅。
清华大学团队在 ACM MM 2026 论文中提出「视觉源幻觉」概念,指出短输出场景下多模态大模型的物体幻觉根植于视觉特征提取与图文嵌入错位,并用 AHAF 与 ACFT 方法仅以 0.9% COCO 数据、零推理开销取得 SOTA。
该项目利用 ChatGPT 4 的图像生成能力,将经典文学作品《桃花源记》转化为互动式可视化图谱,并结合央视著名播音员李立宏的高品质朗诵,旨在帮助学生更好地理解与记忆古文内容。
作者发布自制表情包工具,上传角色图片即可一键生成动图表情,每天提供 300 次共用免费额度。
剪映推出具备 Agent 智能剪辑功能的 AI 助手及创作 Hub,支持批量混剪、视频扩写和自定义技能,旨在打通从创意到发布的视频制作全流程。
MiniMax 以六个全球合作案例展示其模型在公共技能培训、IP 授权创作、垂直模型后训练、小语种继续预训练、芯片推理优化与云平台分发等方向的落地,并借此招募全球化人才。
LlamaIndex 推出 ParseBench,对 100 种文档解析方法进行严格评测,发现 LlamaParse 系列在准确性和成本效率上领先,而图表抽取是普遍瓶颈,视觉语言模型在图像定位方面表现不佳。
阿里发布 Qwen3.8-Omni-Flash 音视频多模态模型,具备 1M 上下文及工具调用能力,大幅减少 Token 消耗,仅提供 API。
腾讯开源 WeVisDoc,支持直接将文档图片转换为 Markdown 格式,并能完整保留复杂的结构、公式与表格。