2026-11-06
呼吁将 Suno 集成至特斯拉车辆
Peter Yang 呼 AEA Suno AI 预装在特斯拉汽车中,构想实现驾驶期间通过语音指令生成音乐的无感体验。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
Peter Yang 呼 AEA Suno AI 预装在特斯拉汽车中,构想实现驾驶期间通过语音指令生成音乐的无感体验。
谷歌发布 Gemini Omni 1.2 Flash,视频生成时长提升至 15 秒,画面一致性大幅优化,价格降至每秒 0.07 美元,对创作者和开发者均有显著提升。
ElevenLabs支持用户将AI音乐直接发布至SoundCloud · · Nov 6, 2026 32.1k 音频人工智能公司 ElevenLabs 于2026年11月5日宣布,正式允许用户将通过其 ElevenMusic 平台创建的AI生成音乐直接发布至 SoundCloud 平台
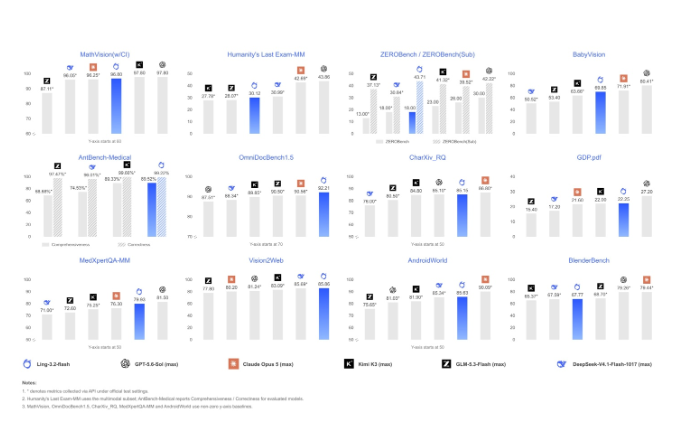
国产多模态新星:蚂蚁 Ling 3.2 Flash 叫板 Claude Opus 5 · · Nov 6, 2026 蚂蚁百灵今日推出原生多模态模型 Ling-3.2-flash,560B 总参数每次仅激活 25B,配 1M 上下文、走 MoE 路线——前向只调部分参数,留知识容量、压单步开销。这"大骨架、小激活",正是平衡能力的核心
Gemini Omni 1.2 Flash 现已在 Krea 上线。 15 秒片段、更深入的电影级控制,以及多轮编辑! 立即试用 👇
蚂蚁百灵团队发布原生多模态模型 Ling-3.2-flash,总参数 560B、激活参数约 25B,上下文窗口 1M,支持图像、文本与视频输入。
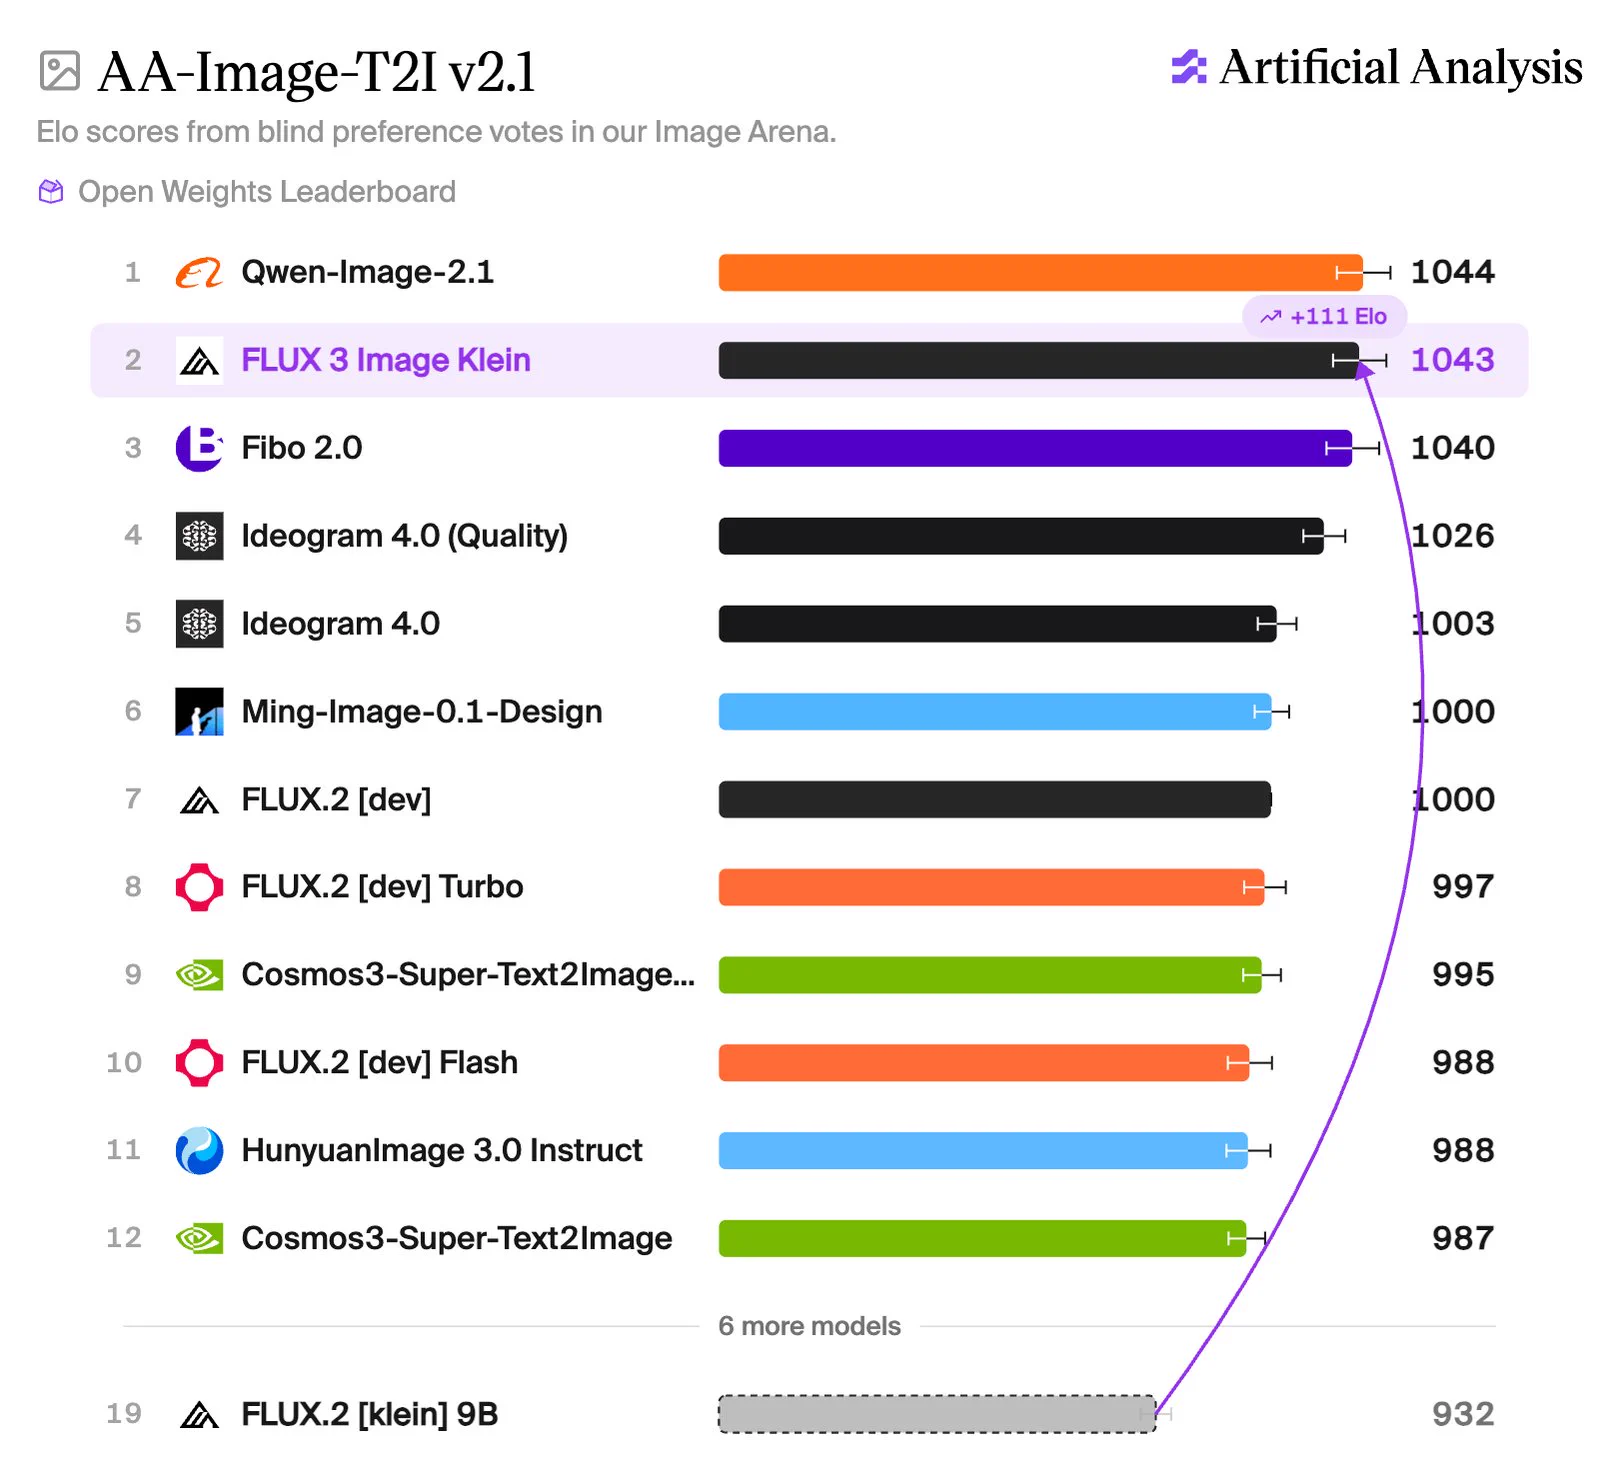
Artificial Analysis 评测显示,Black Forest Labs 的 FLUX 3 Image Klein 在 AA-Image-T2I v2.1 上位列开源权重模型第二,与第一名 Qwen-Image-2.1 不相上下,在 AA-Image-Editing v2.1 上排开源权重模型第三。
Google 发布视频生成与编辑模型 Gemini Omni 1.2 Flash,原生片段时长从 10 秒延长到 15 秒,720p 价格降至 $0.07/秒,比 Omni 1.1 Flash 便宜约 30%,一段 15 秒 720p 视频约 $1.05。
IT之家 11 月 6 日消息,谷歌正式推出 Gemini Omni 1.2 Flash 视频生成模型,并在 Gemini API 与 Gemini for business 平台全面开放使用
OpenAI 相关负责人称,目前 ChatGPT 与 API 每周生成的图像超过 40 亿张,高于仅 8 周前的每周超 30 亿张。其转发的 @OpenAI 内容还提到 ChatGPT Images 2.6 新增 GIF 与参考图支持,API 将迎来两个图像生成速度提升 50% 的新模型。
Krea AI 官宣推出全新 Krea Video,主打在浏览器内直接生成好莱坞级画质视频。功能包括电影感相机控制、100+ 热门预设、可直接用于 UGC 的模板、视频剪辑、风格迁移和声音生成,现已开放试用。
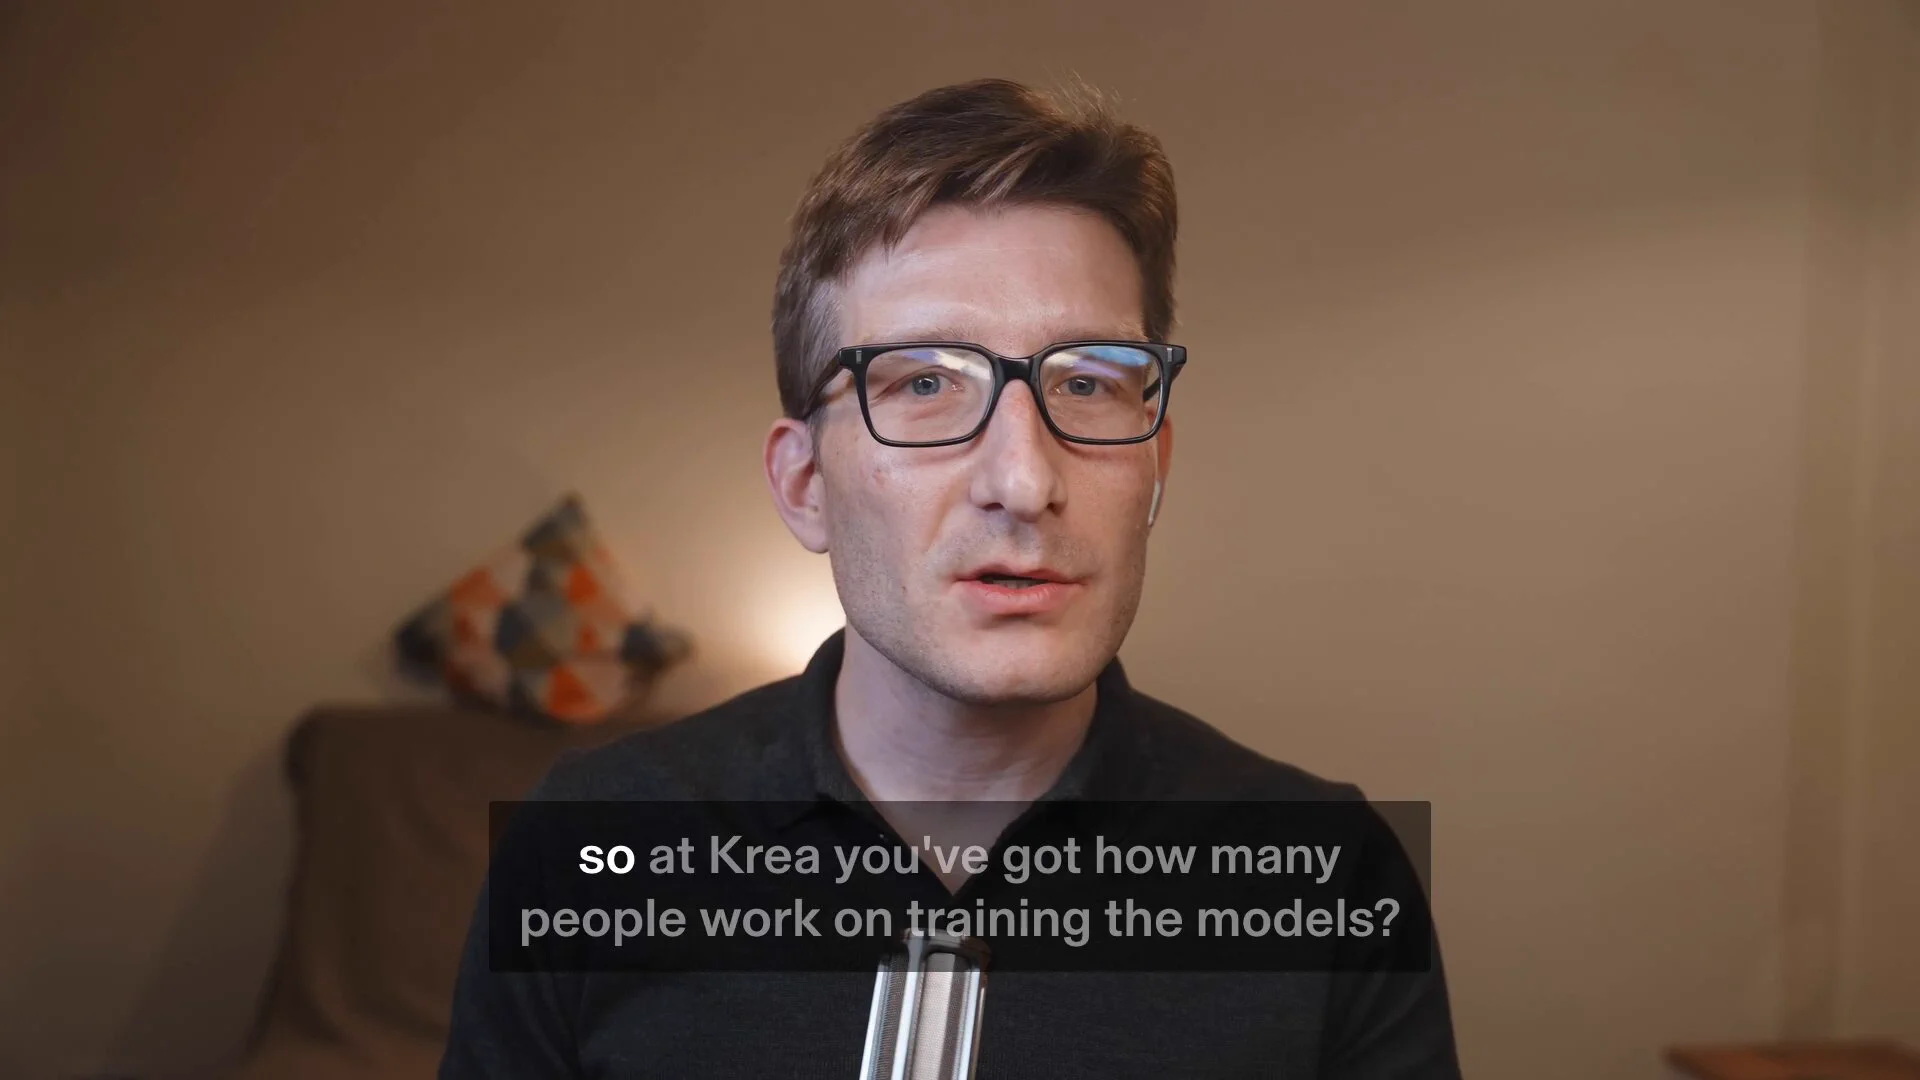
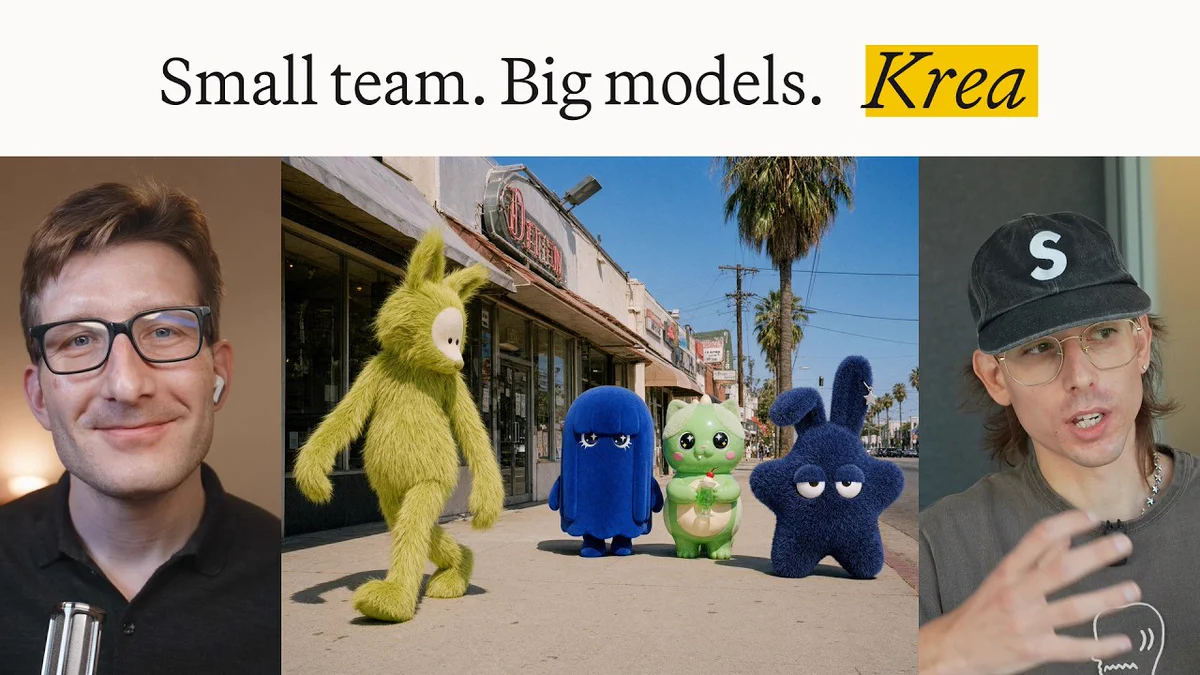
Arena 发布访谈预告,Krea 联合创始人兼 CEO @viccpoes 与 @petergostev 对谈,介绍仅 7 人团队训练 Krea 3 Ultra 的过程
fal 宣布 Google gemini-omni-flash v1.2 在其平台开放试用,提供 Text-to-Video、Image-to-Video、Reference-to-Video、Edit、Extend、Upscale 六个功能的入口链接。
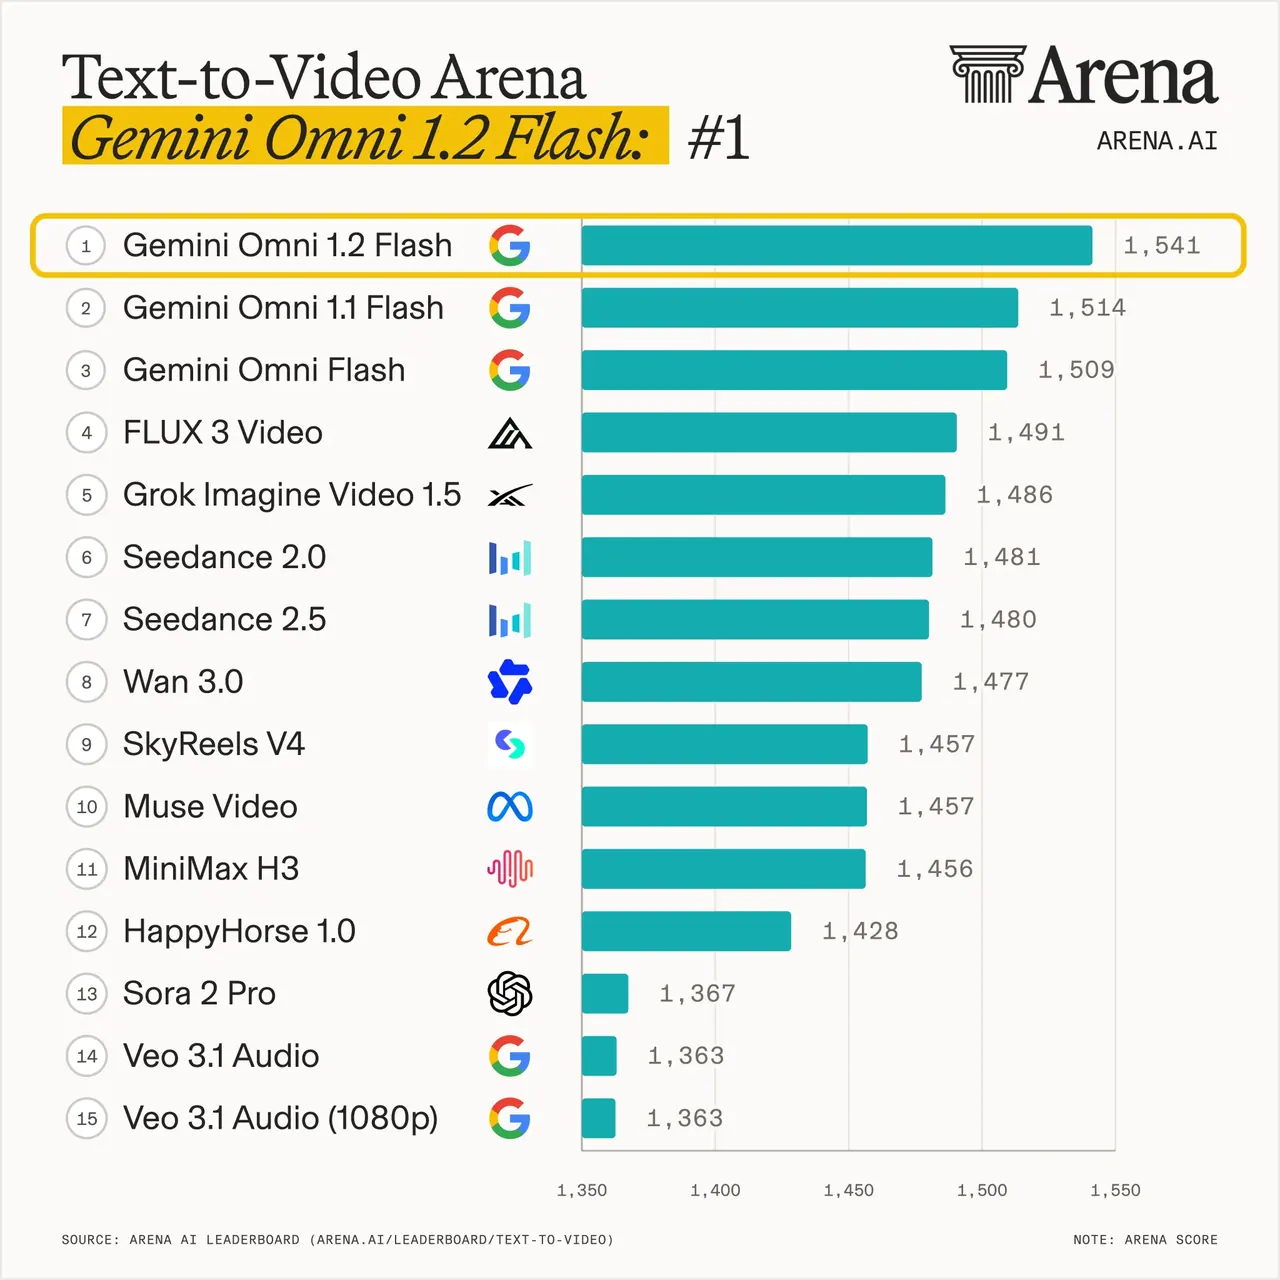
Arena 宣布 Google 的 Gemini Omni 1.2 Flash 在 Text-to-Video 和 Image-to-Video 榜单首秀即排名第一,Video Edit 排第三
在多图编辑竞技场(Multi-Image Edit Arena)中,@krea_ai 凭借最新发布的 Krea 3 Ultra 位列实验室总排名第 3
Logan Kilpatrick 宣布 Gemini Omni Flash 1.2 正式推出,视频生成时长提升至 15 秒,并新增相机视角的更深电影级控制与多轮对话编辑支持
Google 发布来自 Google DeepMind 的更新视频生成模型 Gemini Omni 1.2 Flash。草稿可在 360p 或 720p 生成($0.07/s)再放大到 1080p 或 4K,成本降低 30%;支持生成与编辑最长 15s 的视频,可指定 3s 到 15s 的任意时长,并支持在对话中逐轮替换背景、主体或光照
Google 发布 Gemini Omni 1.2 Flash,视频生成与编辑上限提升至 15 秒,API 价格较上一代下降 30%,720p 视频每秒 0.07 美元
Google DeepMind 发布 Gemini Omni 1.2 Flash,在 Gemini API 和 Gemini for business 全面开放,首次实现 Gemini Omni 全面可用。
Google 发布 Gemini Omni 1.2 Flash,在 Gemini API 和 Gemini for business 全面开放。新模型原生支持最长 15 秒视频生成(此前为 10 秒),支持多轮对话编辑和更强的参考图一致性,价格较 1.1 下降 30% 至 720p 视频 $0.07/秒。
OpenAI 推出 Private Safety Processing,让 OpenAI 为安全目的审查相关 API 请求,同时不留存你的提示词或响应。记录保留在用户自己的环境中,由自动化安全智能体审查,OpenAI 人员无法访问相关内容。
Runway 发布新研究《Runway Characters: Serving a 57B Video Diffusion Transformer for Real-Time Conversation》,讲解如何让约 57B 参数的自回归视频扩散 transformer 以 24 fps 支撑可对话的实时虚拟角色。
ElevenLabs 与 SoundCloud 达成合作,用户可将生成的音乐直接发布到 SoundCloud,无需先导出下载再上传。SoundCloud Artist Pro 订阅者还可免费获得三个月 ElevenMusic Pro。从 ElevenLabs 直接发布到 SoundCloud 的歌曲会被标注,以说明其 AI 来源。
MiniMax Design 用自家 H3 模型演示生成中国古代成语故事的「档案监控录像」风格视频。引用的创作者流程为:先用人物和庭院做参考图,再把落水、想办法、砸缸、救人分段生成并固定机位,最后用 VCR OSD Mono 与 GNU Unifont 绘制低分辨率点阵时间戳,经轻微模糊放大后用 FFmpeg 叠加到视频上模拟老监控字幕。
作者用商汤 SenseNova-6.8-Flash 挑战复刻 Opus 5.5 风格的代码动画,并扩展到 UI、3D 和 SVG 动态海报四类 AI 生成产物。
文章通过对 SenseNova-6.8-Flash 模型的四类案例实验(代码动画、UI、3D、SVG 动态海报),展示了结合 vibecoding-humanizer Skill 后显著降低 AI 生成内容的刻板印象,提出系统化的 AI 味消除方法论。
作者探讨 AI 在公众号内容创作中的应用潜力,坦言技术可蒸馏内容,却无法替代个人热情与独特性。
作者指出 ChatGPT Images 2.6 新增 GIF 功能,显著提升了动态表情包的制作便利性。
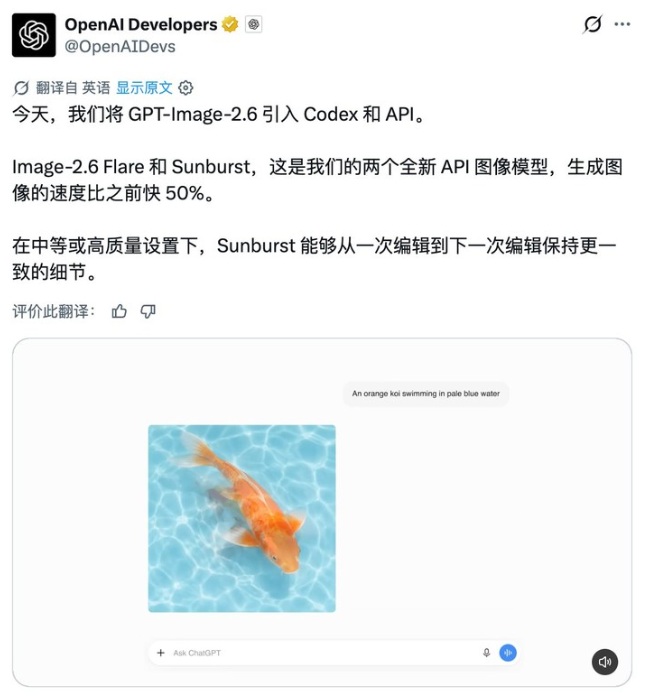
OpenAI 在 ChatGPT、Codex 和 API 上线 Images 2.6,API 端分为 GPT-Image-2.6 Flare 和 Sunburst 两个模型,官方称生成速度比此前快 50%,Flare 在低质量下最快 6 秒出图。
从"能画"到"能改":OpenAI 用 Images 2.6 补齐生图工作流 · · Nov 5, 2026 OpenAI 在官方博客里亮出了一组数字:如今全球用户每周通过 ChatGPT、Codex 和 API 创建的图片已达40亿张,日均超过5亿张。 当 AI 生图走到这个量级,行业的痛点早已不再是"能不能画出来",而是"画完之后能不能方便地改"