2026-11-11
Codex 与 ChatGPT 接入 Runway 插件
借助 Codex 和 ChatGPT 中的 @runwayml 插件,你可以查看原型中角色的动作效果,为预告片尝试不同的开场镜头,或将产品照片转化为视频广告。 Anthony Maggio 分享了 Runway 营销团队如何利用 ChatGPT Image 每周产出更多素材。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
借助 Codex 和 ChatGPT 中的 @runwayml 插件,你可以查看原型中角色的动作效果,为预告片尝试不同的开场镜头,或将产品照片转化为视频广告。 Anthony Maggio 分享了 Runway 营销团队如何利用 ChatGPT Image 每周产出更多素材。
Arena 宣布 MiniMax 的 H3-Image 图像生成模型已上线 Arena,用户可在 Battle Mode 中用创意提示词测试并投票,评分将陆续公布
Scribe v3 Live 现已在 ElevenAgents 中上线,两款模型均可在 ElevenAPI 中使用。Scribe v3 同时也是 ElevenLabs 应用中的默认模型。 了解更多:https://elevenlabs.io/blog/scribe-v3
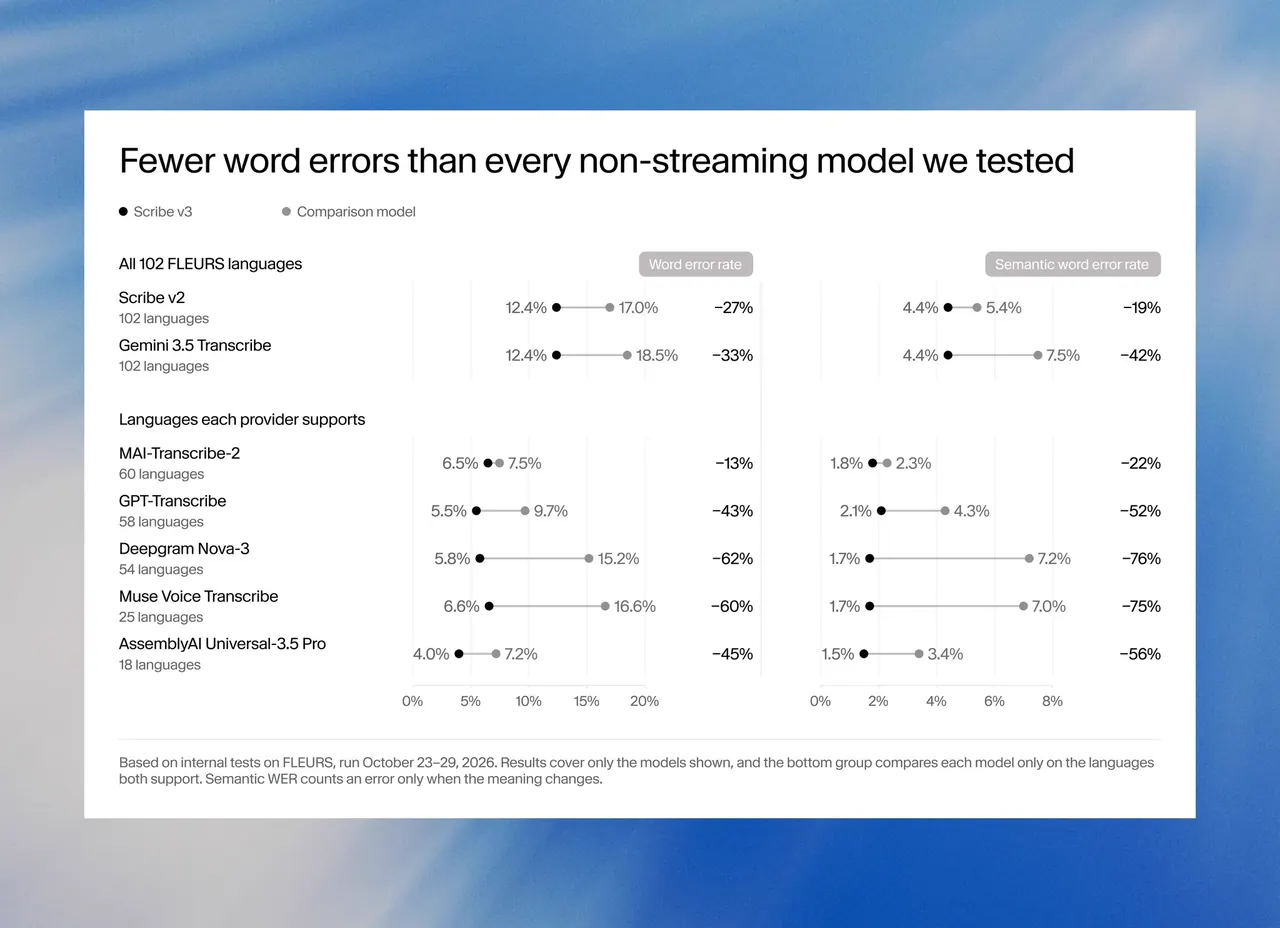
ElevenLabs 发布 Scribe v3,称其在自测中转写与说话人分离准确率优于所有受测模型。Scribe v3 Live 首次支持说话人分离,错误比上一代减少 43%,转折检测改用整段对话判断,新增最多 1 万条关键词库并支持用自然语言编辑转写。在 ElevenAgents 中,Eneco 的语音代理对荷兰语邮编的一次识别正确率提升 40%。
推出 Scribe v3 和 Scribe v3 Live:这是我们迄今最准确的语音转文字模型。 Scribe 专为真实场景音频打造,在极端背景噪声环境中表现出色,能区分句末停顿与句子结束,还能在繁忙会议中追踪谁说了什么。
fal 宣布 MiniMax H3 Image 现已上线其平台,未来两周提供免费生成额度,入口为 https://fal.ai/minimax-h3-image。该模型为 MiniMax_AI 最新开源权重图像模型,支持原生 4K 生成与编辑、多参考图组合以及精准渲染复杂文字。
一个字符。完整营销活动。无需离开对话。Luma MCP 现已在 ChatGPT 和 Claude 中上线。
现在轮到你们了,创作者们。 尽情发挥吧!!!我们迫不及待想看到你们构建的作品。🚀
🖼️最多16张参考图。全部10秒完成。⚡️
MiniMax 发布基于 H3 的开源权重图像生成模型 H3-Image,支持文生图、参考图生成和图像编辑,可生成 4096 × 4096 的 4K 图像,速度最高达主流方案的 5 倍。
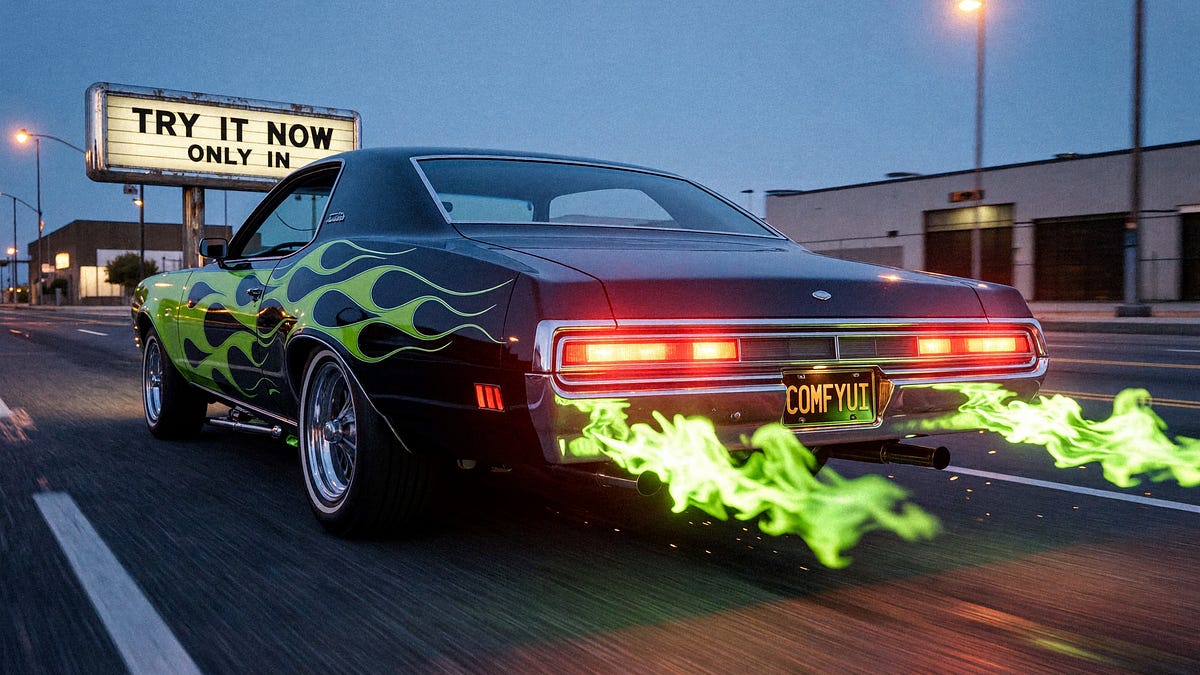
MiniMax H3 Image 现已获得 ComfyUI 原生支持,模型开源权重、6 步采样、最高可输出 4096×4096 分辨率,单个 checkpoint 同时覆盖文生图和参考图编辑。
fal 发帖推介 MiniMax 的图像编辑功能,可通过精确的指令式编辑变换图像。该功能支持添加、移除或替换物体,更改风格与环境,并可渲染复杂文字、信息图和 UI 布局,同时保留重要的细节。
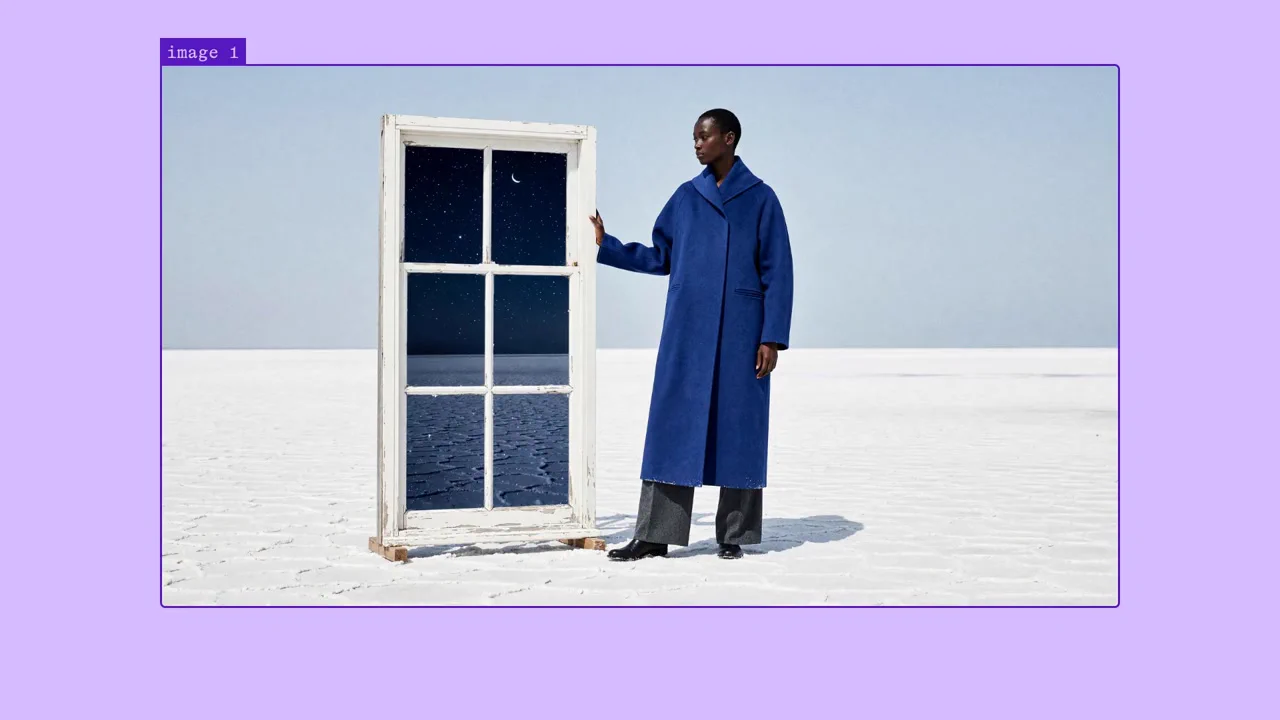
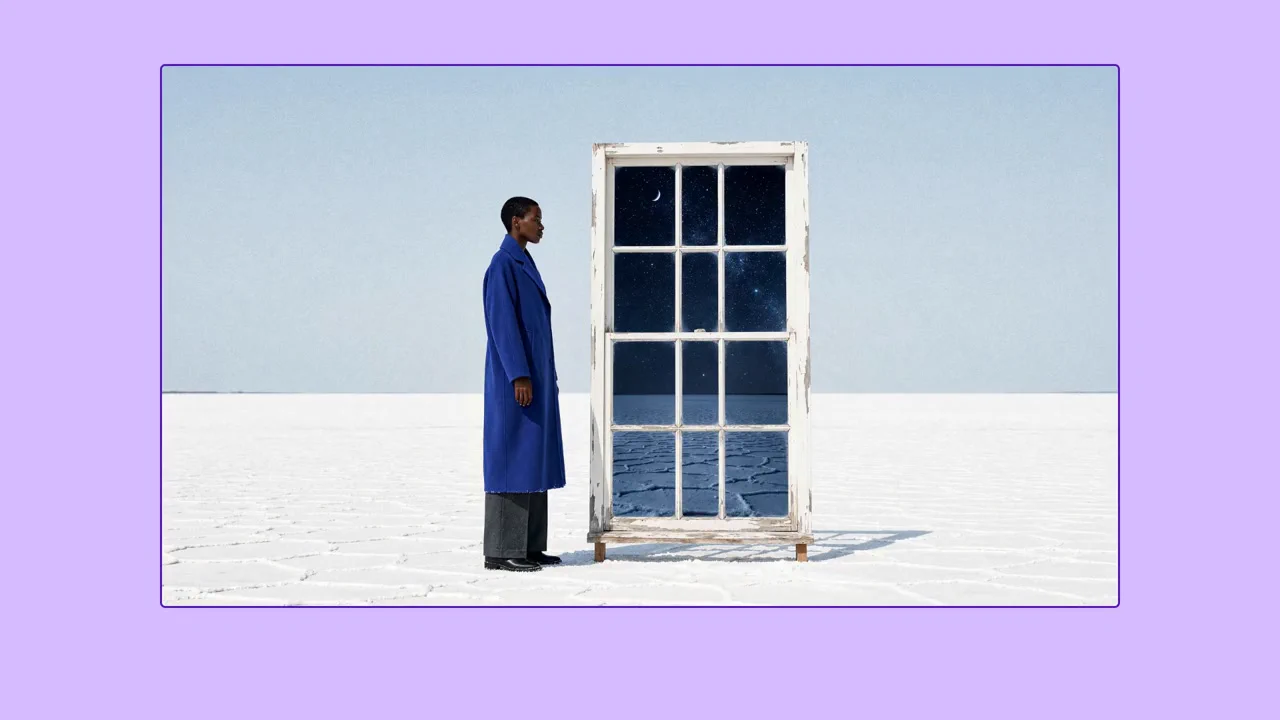
@MiniMax_AI 将多张参考图合成为一张连贯统一的结果。 把来自不同来源的角色、物体和环境融合在一起,同时保持视觉一致性,并掌控最终构图。
fal 发文介绍 MiniMax H3 Image 图像模型,称其图像质量达到前沿水平且速度出色。该模型支持任意宽高比的原生 16MP 分辨率,并可在约 15 秒内完成 2K 图像编辑。
fal 宣布 MiniMax 的开源权重图像模型 MiniMax H3 Image 现已在 fal 平台可用。该模型支持原生 4K 图像的生成与编辑,可结合多张参考图,并能精确渲染复杂文字,视觉质量高且生成速度快。
Krea 宣布 Seedream 5.5 现已在 Krea 平台可用。新版本支持对同一图像最多编辑 100 次而不损坏画面,可原生生成透明 PNG,并改进了文字生成效果。
MiniMax 发布开源图像模型 MiniMax H3-Image,支持 10 秒内生成 1600 万像素(4K)图像,具备精准提示词遵循与编辑能力,最多支持 16 张参考图。模型开放权重,已通过 API、MiniMax Code 和 Hailuo AI 提供,上线首周 16MP 以上生成享五折优惠,权重已上架 Hugging Face。
MiniMax 发布开源权重图像生成模型 MiniMax H3-Image,主打 10 秒内生成 1600 万像素(16MP)4K 图像,支持精准提示词跟随、编辑和最多 16 张参考图。
IT之家 11 月 10 日消息,今天(10 日)深夜,MiniMax 宣布,MiniMax H3-Image 正式发布并 开放权重 。这是一款衍生自 H3 的图像生成模型,其具备 文本生成图像、图像参考和图像编辑能力
作者说明视频中白模动画由 Fable 5.2 制作,角色动画通过调用 Seedance 视频模型生成。
MiniMax 正式发布并开放权重的 H3-Image 是衍生自 H3 的图像生成模型,支持文本生成图像、图像参考和图像编辑。它可在 10 秒内生成 4096×4096 像素约 16MP 的图像,官方称速度达市面主流的 5 倍,指令遵循能力为开源模型中最强并最多支持 16 张参考图。
MiniMax 发布 H3-Image 开源模型,支持 4K 图像生成,10 秒出图,速度提升 5 倍,价格低于同档位 50%-70%,并首周提供五折优惠。
IT之家 11 月 10 日消息,在今天(10 日)于迈阿密举行的 Adobe MAX 大会上,Adobe 公布了一系列新功能: 第三方 AI 智能体能直接访问和修改 Creative Cloud 项目、升级 Firefly AI 助手,支持智能体在后台持续处理定期任务
MiniMax 发布图像模型 MiniMax H3-Image 并开源模型权重,可在 10-20 秒内生成 4K × 4K(16 million pixel)图像。
Adobe 在迈阿密 MAX 大会上宣布向 Photoshop、Premiere、Illustrator 和 InDesign 注入更多 AI,并扩展 Firefly 的创意 AI 智能体。
作者 @aiwarts 自称灰度抽到 GPT-6.2 Sol,用 7 组提示词在 Codex 中实测代码动画、3D 可视化、UI 生成和 AI 剪辑
作者借助 Fable 5.2 与 three.js 等工具制作了塞尔达公主风格动态桌面壁纸,同时观察到 GPT-image-2.6 版权审核尚未收紧。
该功能允许用户在浏览视频时直接截取片段并添加看法,实现在线剪辑,解决内容创作匮乏问题。
本文从评估测试、运行时防护、监测审计、安全运营、基础设施与算力安全五个维度,梳理阿里云、腾讯云、天融信等八家厂商在AI安全领域的主要产品落点与能力边界。
11 月 10 日,Anthropic 发布 Claude Fable 5.2 与 Mythos 5.2,字节跳动推出 Seedream 5.5 图像生成模型,美团开源 LongCat-2.5 模型权重,同时汇总了 Meta Muse Ember、LG K-EXAONE 2.5 与 Shizuku-Duplex 等多项 AI 项目动态。