2026-11-11
探索 AI 辅助的历史解说视频创作与抖音推广难题
作者尝试用 AI 生成独特角度的'持械入宋'解读视频,数据不错,但随后遭遇抖音限流和短剧推广规则的挑战,探讨是否可以通过 AI + 分佣模式突破瓶颈。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
作者尝试用 AI 生成独特角度的'持械入宋'解读视频,数据不错,但随后遭遇抖音限流和短剧推广规则的挑战,探讨是否可以通过 AI + 分佣模式突破瓶颈。
MAX 2026 一周之内,Adobe 把入口开给 ChatGPT 与 Claude,模型选择器接入 Runway 与 Kling,云端算力改按积分计费;迪士尼联盟补上企业客户的 Firefly Foundry 封闭模型这一块。视频擦除按秒扣积分、规格锁在 1080p,本地 MCP 仍在 2027 年初私测计划内。
EnConvo 是一款功能全面的 macOS AI 助手,通过集成外接模型能力和全局快捷操作,实现系统级的 AI 自动化与多媒体创作支持。
AI 大模型也赶双 11:智谱、MiniMax 与阿里云等集体开启低折扣促销 · · Nov 11, 2026 32.2k 大模型厂商迎来史上最热闹的双11促销季
作者实测火山引擎新发布的 Seedream 5.5,与 GPT Image 2.6 在同一底图上连续修改 30 轮,Seedream 5.5 人物与画面保持稳定,Image 2.6 出现明显形变和油腻感。
MiniMax 官方感谢 Runware 对 MiniMax H3 Image 的 Day 0 支持,该图像模型基于开源视频模型 H3 构建,定位广告创意、电商与规模化内容生产
MiniMax 宣布 H3 Image 图像模型在 fal 上线,官方称约 10 秒即可生成 4K 图像。模型能遵循复杂提示词、精确编辑,并支持游戏与 3D 资产生成,官方表示其速度足以支撑智能体和生产力工具。引用的 fal 介绍称其支持原生 4K 生成与编辑、多参考图组合及精确文本渲染。
Fable 5.2 通过 Claude Code 和 67.js 渲染,制作了 44 秒左右的 3D 动画,科学解读了芝诺悖论及“手指不接触”的原子物理现象,但指出两者不可直接等号联系。
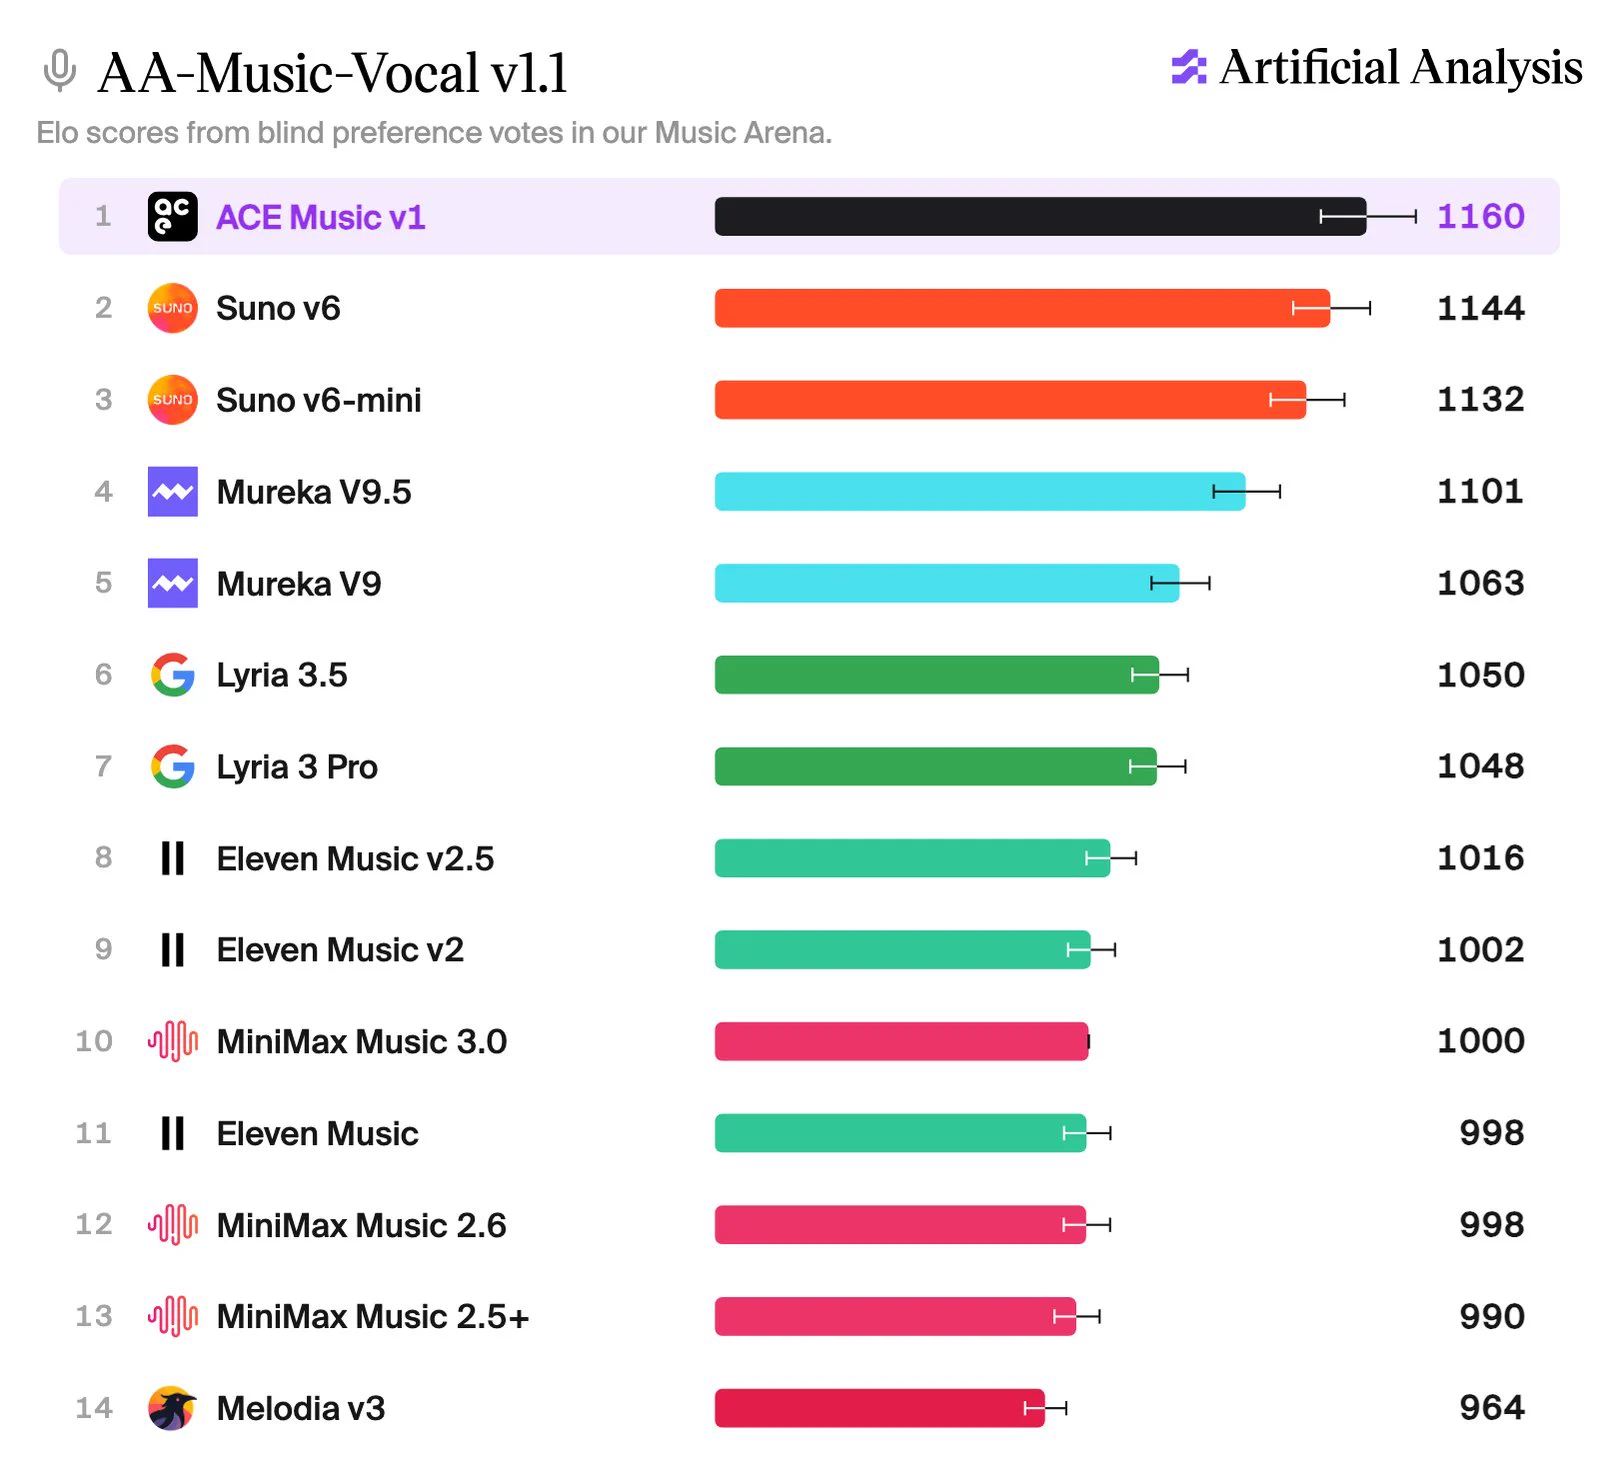
ACE Studio 的 ACE Music v1 在 Artificial Analysis AA-Music-Vocal v1.1 榜单首秀即排第一,领先 Suno v6。
IT之家 11 月 11 日消息,摩尔线程今天宣布,公司旗下 AI 训推一体智算卡 MTT S5000 及 MUSA 软件栈, 已在昨天(开源当日)适配 MiniMax 图像生成模型 H3-Image
MiniMax 震撼开源 H3 Image 模型:定位全球第一梯队,支持 4K 图像秒级直出 · · Nov 11, 2026 人工智能开源生态再度迎来重量级突破。国内人工智能企业 MiniMax 近期正式发布并开源了其全新的图像生成模型——H3 Image
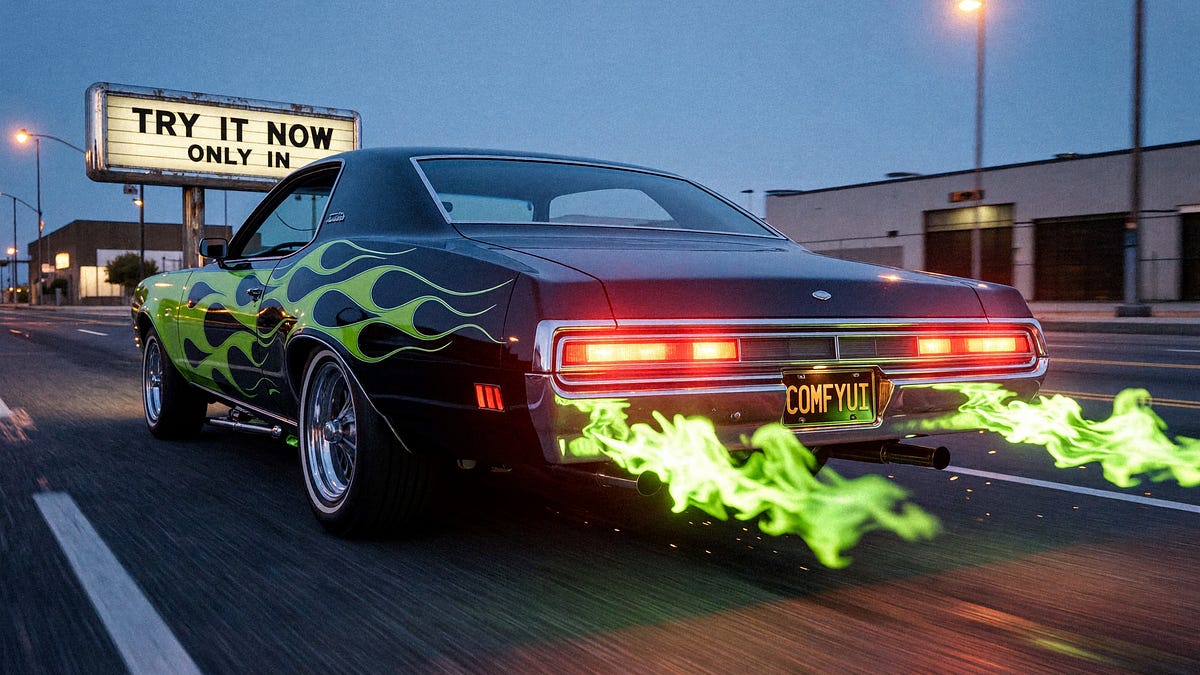
Seedream 5.5 现已通过 Partner Nodes 在 ComfyUI 中可用,这是一个支持文本生成和图像编辑的多模态模型。能力方向包括原生 RGBA 透明生成、多轮局部编辑(只改描述区域、其余画面保持不变)、可读文字的海报与信息图排版、更真实的肖像质感以及提示词控光。
作者实测 Claude Fable 5.2 与 Gemini 4 Carbon 并对比后认为,Fable 5.2 的突出差异在于审美,这是无法用 Benchmark 评估但可直观感受的东西。
IT之家 11 月 11 日消息,当地时间 11 月 10 日,谷歌宣布联合 AI 模型评测机构 Artificial Analysis 推出多模态知识智能体基准测试 MKA(Multimodal Knowledge Agent),用于评估 AI 智能体处理视觉复杂文件、完成现实世界知识工作任务的能力
借助 Codex 和 ChatGPT 中的 @runwayml 插件,你可以查看原型中角色的动作效果,为预告片尝试不同的开场镜头,或将产品照片转化为视频广告。 Anthony Maggio 分享了 Runway 营销团队如何利用 ChatGPT Image 每周产出更多素材。
Arena 宣布 MiniMax 的 H3-Image 图像生成模型已上线 Arena,用户可在 Battle Mode 中用创意提示词测试并投票,评分将陆续公布
Scribe v3 Live 现已在 ElevenAgents 中上线,两款模型均可在 ElevenAPI 中使用。Scribe v3 同时也是 ElevenLabs 应用中的默认模型。 了解更多:https://elevenlabs.io/blog/scribe-v3
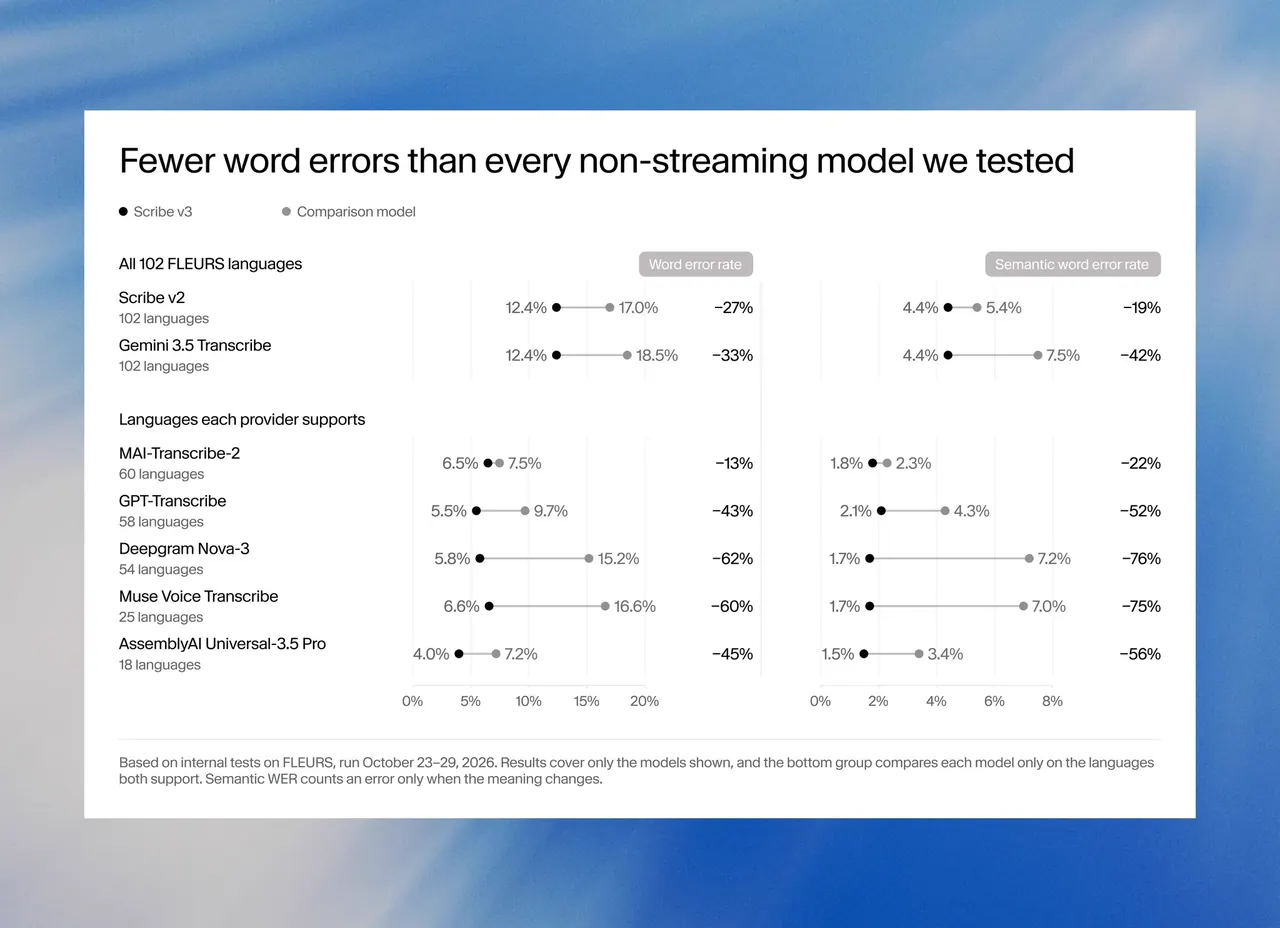
ElevenLabs 发布 Scribe v3,称其在自测中转写与说话人分离准确率优于所有受测模型。Scribe v3 Live 首次支持说话人分离,错误比上一代减少 43%,转折检测改用整段对话判断,新增最多 1 万条关键词库并支持用自然语言编辑转写。在 ElevenAgents 中,Eneco 的语音代理对荷兰语邮编的一次识别正确率提升 40%。
推出 Scribe v3 和 Scribe v3 Live:这是我们迄今最准确的语音转文字模型。 Scribe 专为真实场景音频打造,在极端背景噪声环境中表现出色,能区分句末停顿与句子结束,还能在繁忙会议中追踪谁说了什么。
fal 宣布 MiniMax H3 Image 现已上线其平台,未来两周提供免费生成额度,入口为 https://fal.ai/minimax-h3-image。该模型为 MiniMax_AI 最新开源权重图像模型,支持原生 4K 生成与编辑、多参考图组合以及精准渲染复杂文字。
一个字符。完整营销活动。无需离开对话。Luma MCP 现已在 ChatGPT 和 Claude 中上线。
现在轮到你们了,创作者们。 尽情发挥吧!!!我们迫不及待想看到你们构建的作品。🚀
🖼️最多16张参考图。全部10秒完成。⚡️
MiniMax 发布基于 H3 的开源权重图像生成模型 H3-Image,支持文生图、参考图生成和图像编辑,可生成 4096 × 4096 的 4K 图像,速度最高达主流方案的 5 倍。
MiniMax H3 Image 现已获得 ComfyUI 原生支持,模型开源权重、6 步采样、最高可输出 4096×4096 分辨率,单个 checkpoint 同时覆盖文生图和参考图编辑。
fal 发帖推介 MiniMax 的图像编辑功能,可通过精确的指令式编辑变换图像。该功能支持添加、移除或替换物体,更改风格与环境,并可渲染复杂文字、信息图和 UI 布局,同时保留重要的细节。
@MiniMax_AI 将多张参考图合成为一张连贯统一的结果。 把来自不同来源的角色、物体和环境融合在一起,同时保持视觉一致性,并掌控最终构图。
fal 发文介绍 MiniMax H3 Image 图像模型,称其图像质量达到前沿水平且速度出色。该模型支持任意宽高比的原生 16MP 分辨率,并可在约 15 秒内完成 2K 图像编辑。
fal 宣布 MiniMax 的开源权重图像模型 MiniMax H3 Image 现已在 fal 平台可用。该模型支持原生 4K 图像的生成与编辑,可结合多张参考图,并能精确渲染复杂文字,视觉质量高且生成速度快。