2026-11-12
AI 绘画作品《Dusk, Reloaded》完成
a16z 合伙人 Justine Moore 的 Fable 5.2 在 94 分钟内完成 1200×690 的 MS Paint 风格绘画,共用 11,066 笔刷和 261 种颜色,同时生成了配乐和创作说明。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
a16z 合伙人 Justine Moore 的 Fable 5.2 在 94 分钟内完成 1200×690 的 MS Paint 风格绘画,共用 11,066 笔刷和 261 种颜色,同时生成了配乐和创作说明。
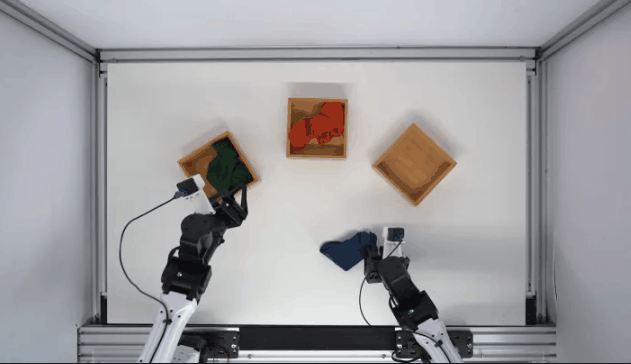
Runway 于 11 月 11 日推出机器人模型 Praxis-1,将视频预训练知识用于真实机器人控制,模型以 Apache 2.0 许可证开放权重,权重和代码分别在 Hugging Face 和 GitHub 公开。
IT之家 11 月 12 日消息,字节火山引擎今日正式推出 Seedance 2.5 flash。 官方表示,这是 当前效果最接近 Seedance 2.5 的模型,生成速度提升一倍,价格更低 ,为批量内容生产提供了更具性价比的选择
火山引擎正式推出 Seedance 2.5 flash,生成速度较 Seedance 2.5 提升一倍,720P 下文生视频、图生视频价格约 0.99元/秒,降低约34%。
Runway 开源 27B 世界动作模型 Praxis-1:登顶机器人权威榜单,全面支持 Apache 2.0 商业开源 · · Nov 12, 2026 人工智能在具身智能领域的竞争迎来了又一个里程碑
IT之家 11 月 12 日消息,谷歌昨日宣布推出 Gemini Decisions API 快速多模态决策,由全新 Gemini Decision 1 模型驱动。该 API 可在 1 次快速处理过程中,对文本、图像、视频和 PDF 内容进行至多 1000 项是非判断、选项选择和标准评估
Google 推出 Gemini Decisions API,由新模型 Gemini Decision 1 驱动,可在 150-250ms 端到端延迟内对文本、图像、音频、视频和 PDF(最多 256K tokens)一次性评估最多 1000 个是/否、多选和评分题。
vLLM-Omni 团队将 MiniMax 开源权重图像生成与编辑模型 H3-Image 带到 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 生成中位延迟 0.866 秒,比 GB200 快 2.21 倍;吞吐配置(SP1×DP4)达 6,115 张/小时。
Runway 宣布世界动作模型 Praxis-1 以 Apache 2.0 开放权重面向所有人开放。该模型为 27B 参数 MoE 扩散 Transformer,同时预测视频与动作,在 NVIDIA RoboLab-120 榜单以 46.2% 成功率居首
Luma AI 宣布 Character Swap & Insert 功能现已上线 Luma,可对已有视频进行角色替换与插入。演示展示了在同一镜头内更换演员、更换汽车、加入一只狗或移除人物等客户常见修改需求。
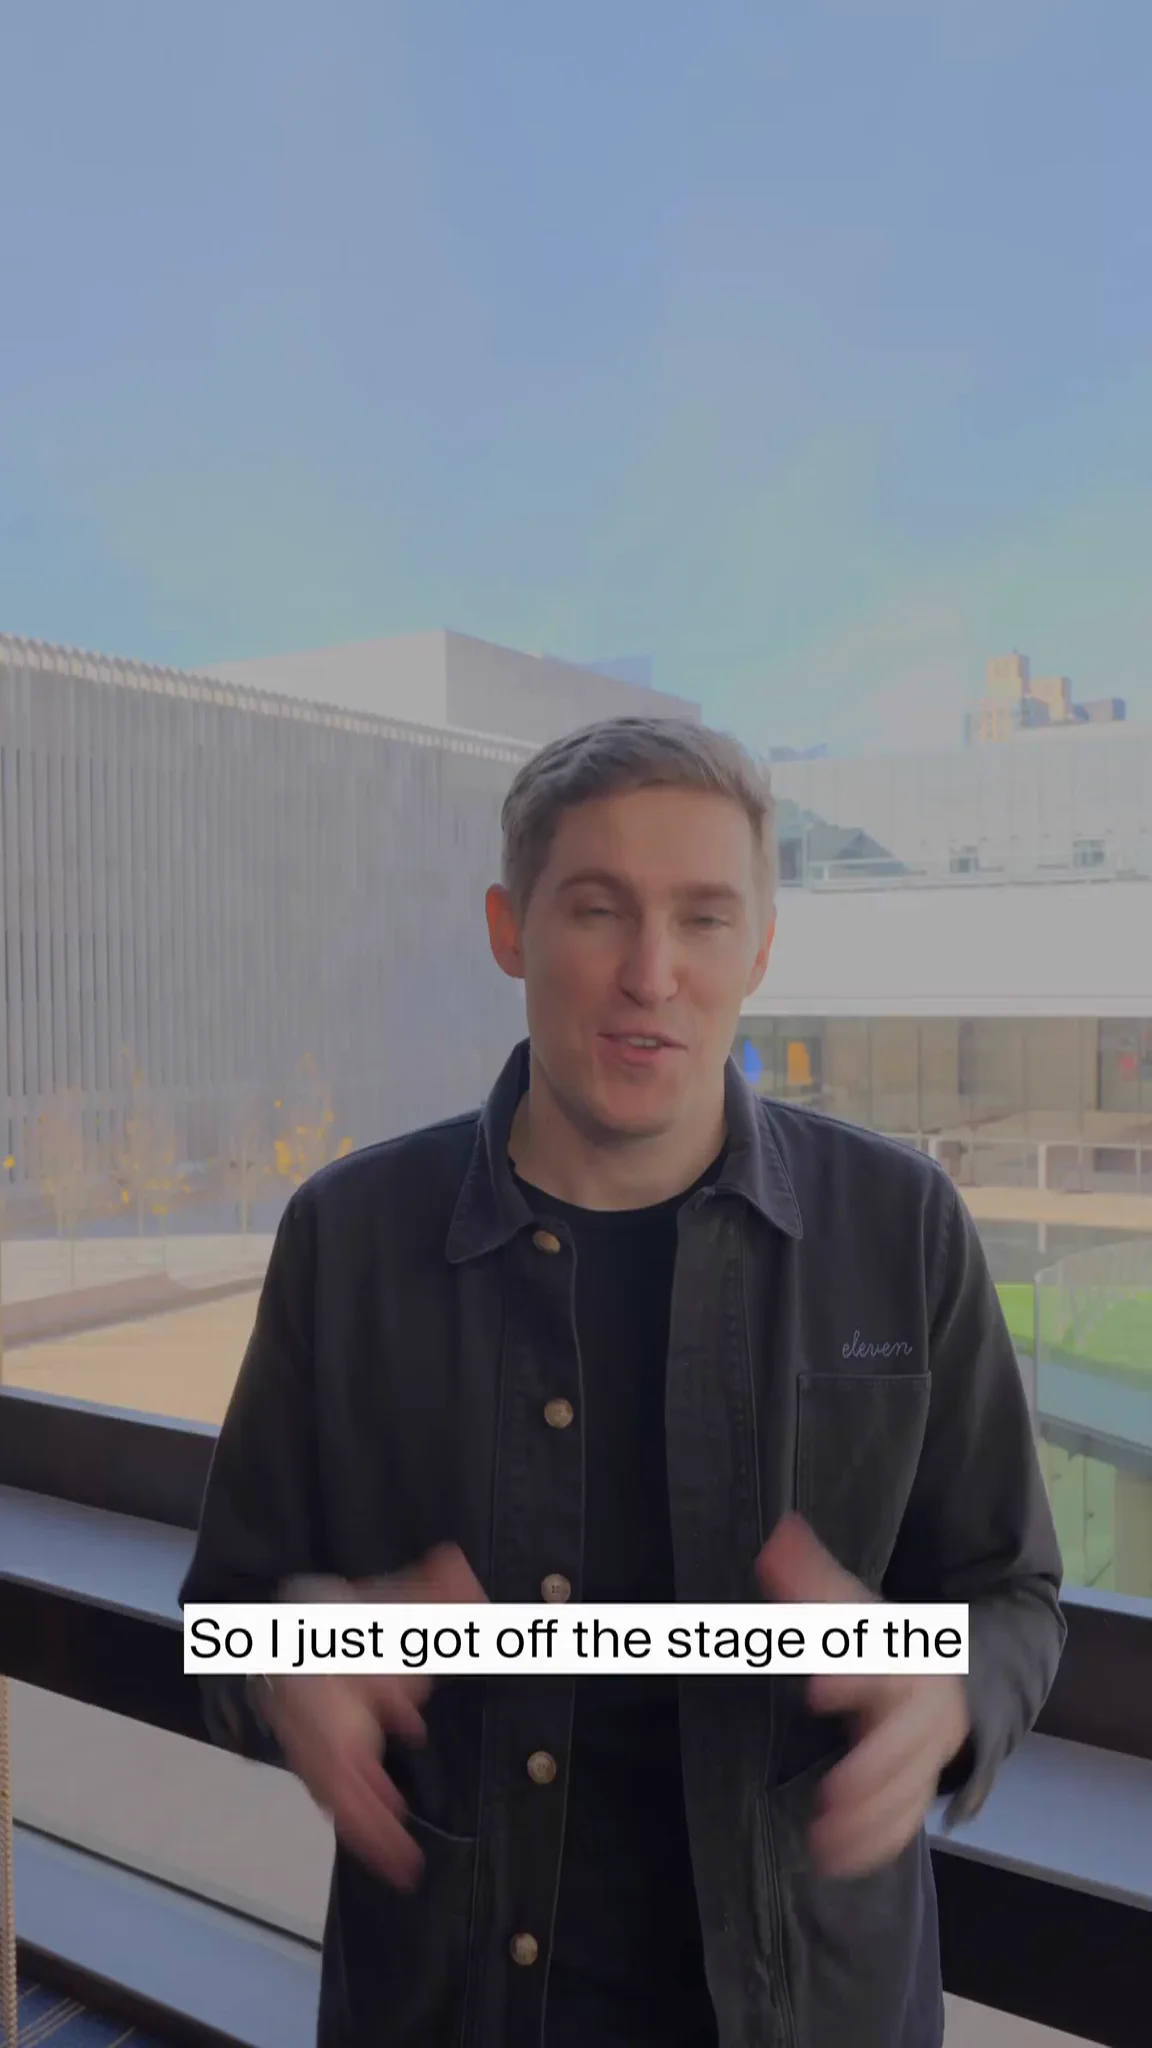
ElevenLabs 在 Summit NYC 上公布五项智能体相关发布:Fine-tuning 允许企业未来几个月用自有数据持续微调其语音模型及开源 LLM。
MiniMax 官方演示其新的开放权重模型 H3 Image 的电商与广告创意用法:从草图或产品图出发,一次生成棚拍到生活方式广告等每个场景都保持一致的画面
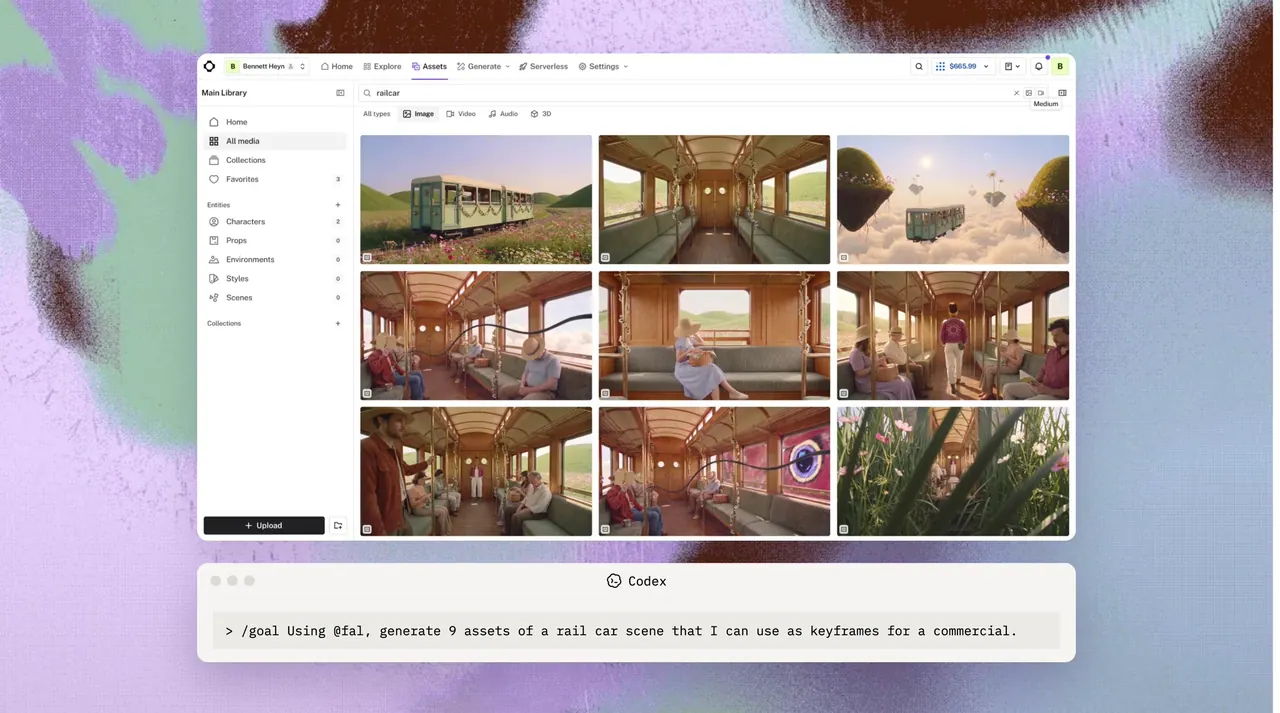
从最初的概念到完成的创意素材,fal ChatGPT 插件将图像和视频生成直接带入你的对话中。 无需离开 ChatGPT,即可使用 GPT Image 2.6、FLUX 3 Max 及其他领先模型进行生成、编辑和迭代。 安装 fal 插件:https://openai.com/business/plugins/fal/
Google 推出 Gemini Decisions API,由新模型 Gemini Decision 1 驱动,可在 150-250ms 端到端延迟内对文本、图像、音频、视频和 PDF(最多 256K tokens)一次性评估最多 1000 个是/否、多选和评分题。
fal 发布 ChatGPT 插件,把图像和视频生成能力带入 ChatGPT 对话。用户可在不离开 ChatGPT 的情况下,用领先的 AI 模型生成、编辑和迭代创意资产,从初始概念到成品。安装地址:https://openai.com/business/plugins/fal/。
使用 fal 插件,直接在 ChatGPT 中生成和编辑图像与视频。 我们用 GPT Image 2.6 生成了数百个关键帧,用 FLUX 3 Max 为 26 个镜头制作动画,并将这一切整合成一支 60 秒的广告。 🧵 以下是我们如何做到的。
优秀的语音智能体必须理解你、听起来像真人,并且响应迅速。 过去一个月,我们推出了三款模型:Scribe v3 提升转写准确率,Eleven v4 实现富有表现力的语音,Eleven Realtime 主打速度。
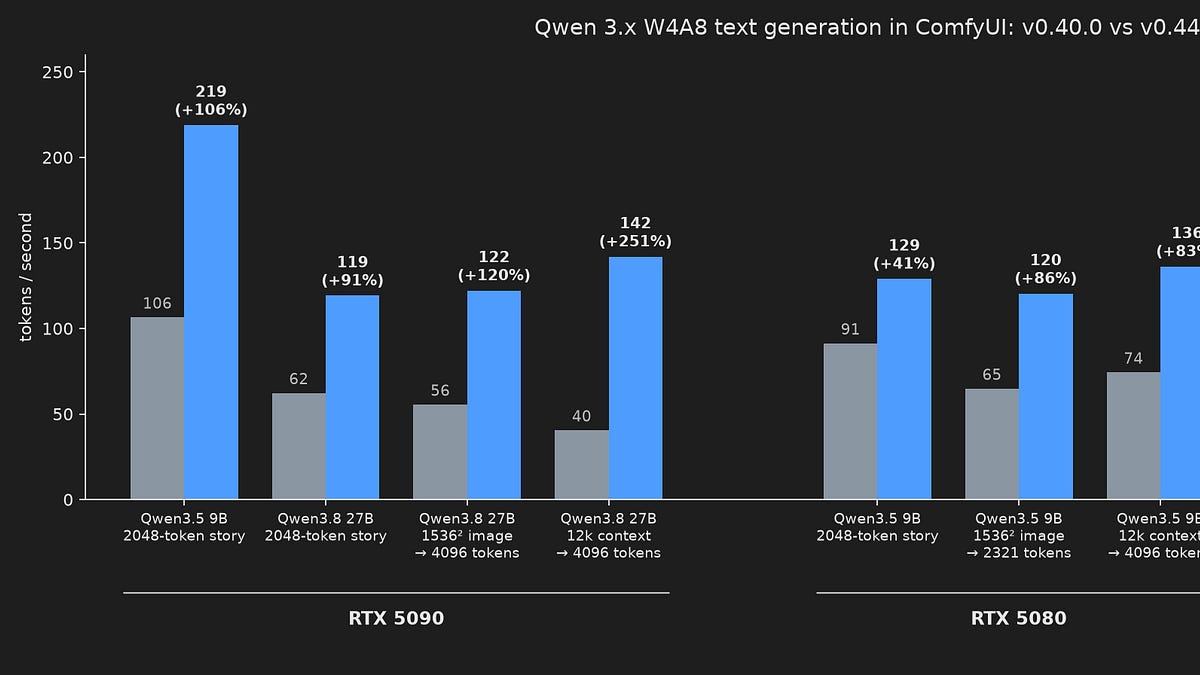
ComfyUI 官方博客讲解其对 Qwen3.x 文本生成热路径的重写,使相同 checkpoint 在相同 GPU 上 token 生成速度最高提升约一倍,改进已随 ComfyUI v0.45.0 提供。
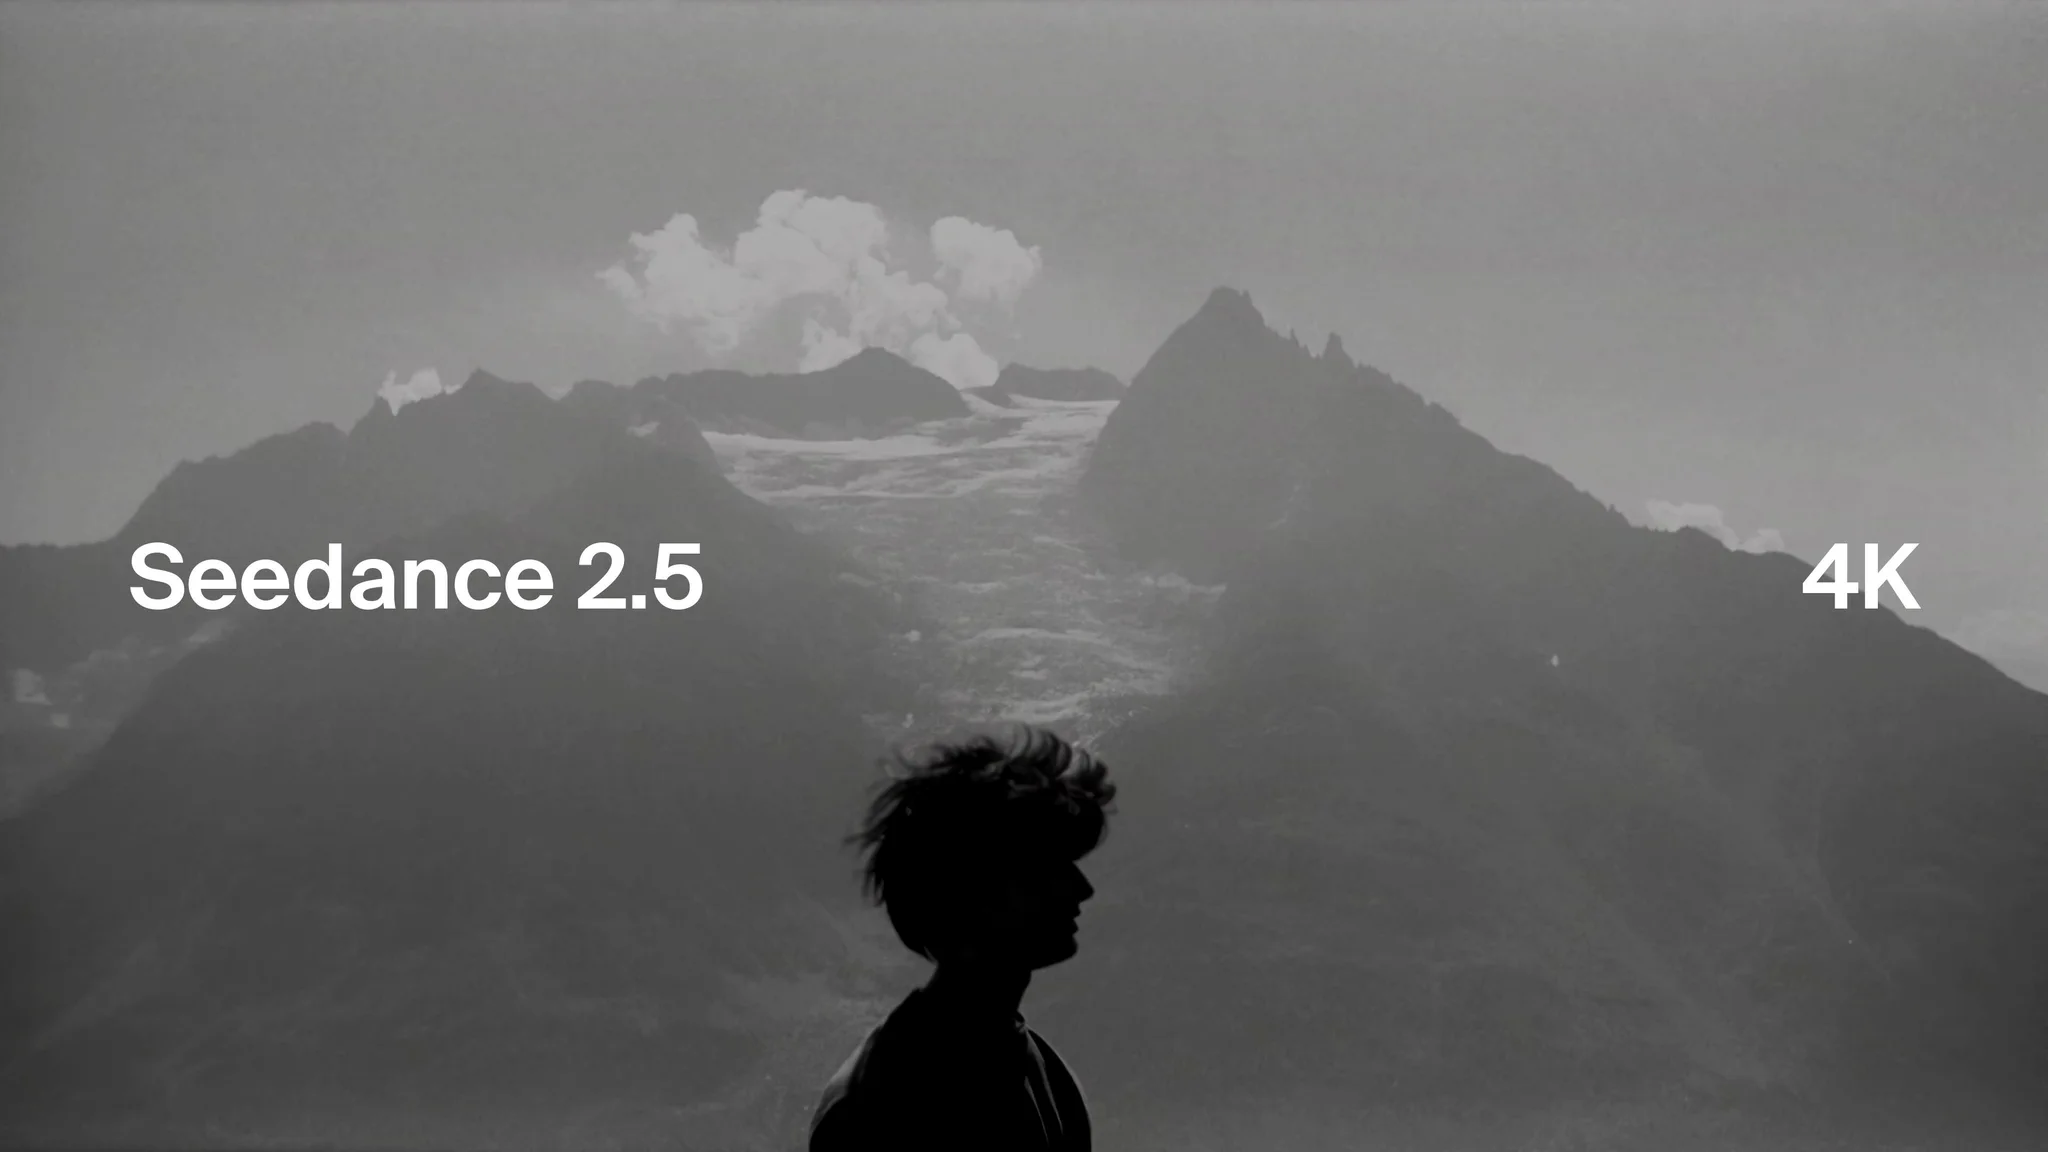
Seedance 2.5 4K 现已登陆 Krea。 迄今画质最高的 AI 视频模型。 立即体验 👇
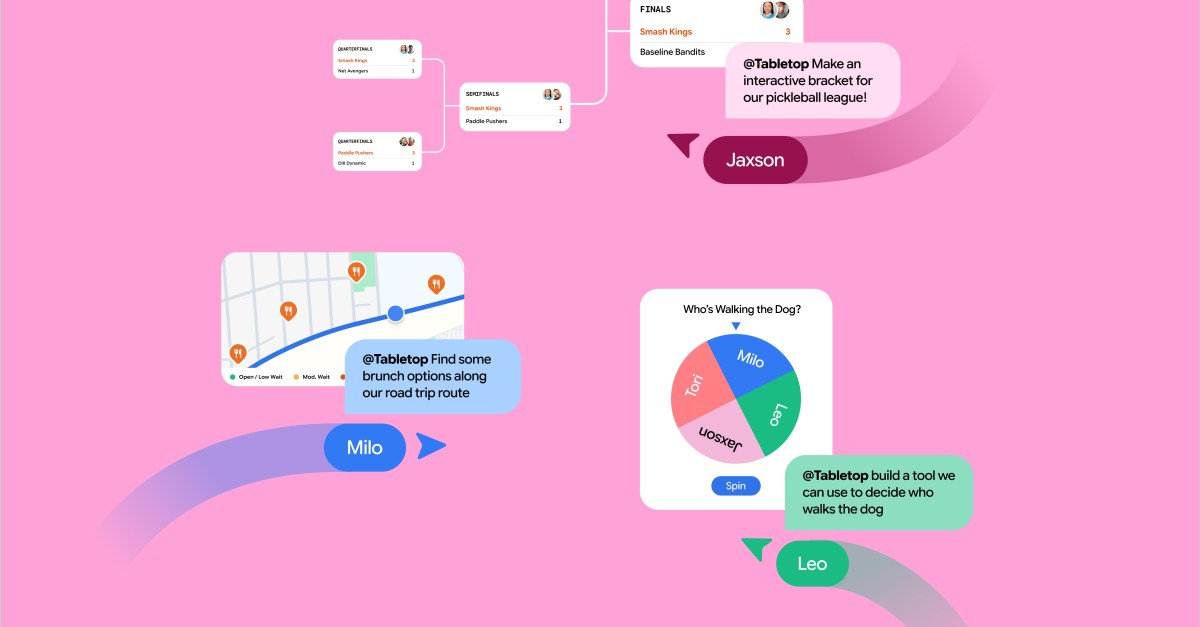
Google 推出名为 Tabletop 的实验性 AI 工具,可通过描述需求生成储蓄追踪、家务表、行程规划等自定义协作工具。用户添加链接、文件和想法后提示 @tabletop 或选用模板即可生成,再把邀请链接发到群聊,多人可像 Google Doc 一样同时使用。Tabletop 测试版通过等待名单开放,目前仅限美国 18 岁以上用户。
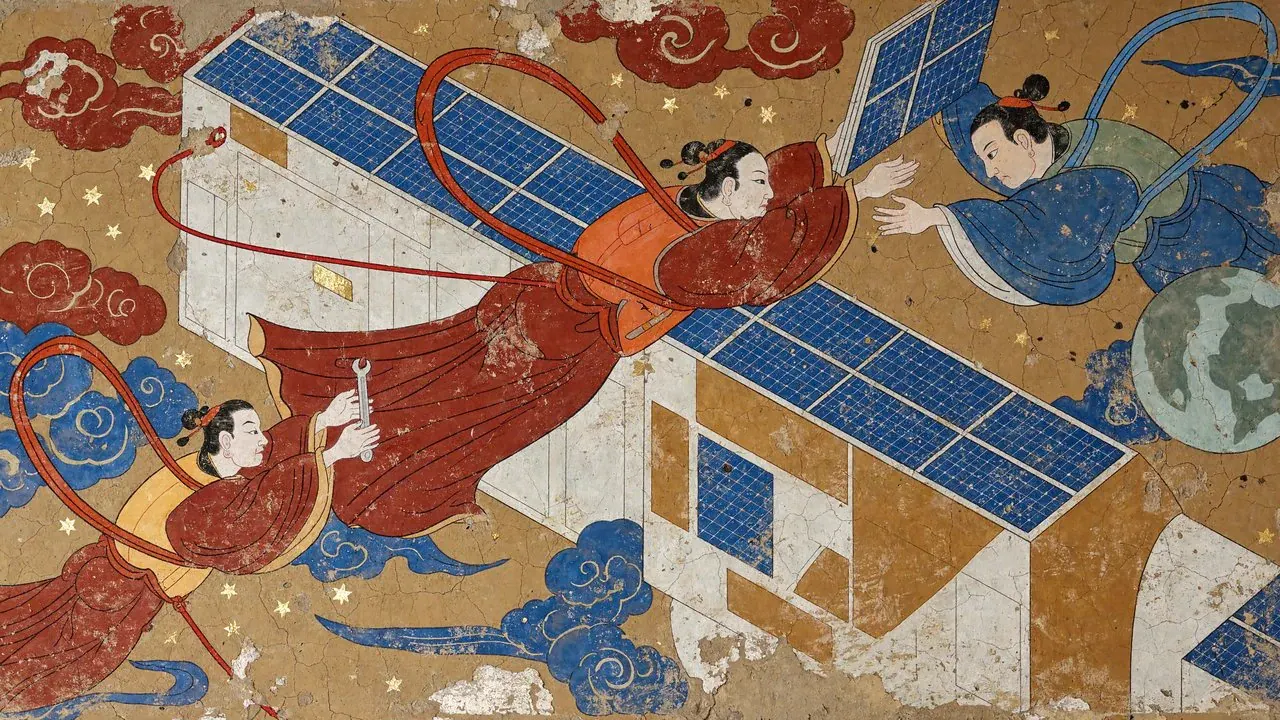
MiniMax 官方分享一幅以传统艺术语言表现现代题材的图像生成示例,主题为唐代敦煌土墙壁画风格的现代空间站外部维护。正文附完整提示词,指定飞天式技术员、石青色太阳能板方块、矿物颜料颗粒与自然剥落等细节,并明确排除科幻盔甲和摄影式星空等元素。
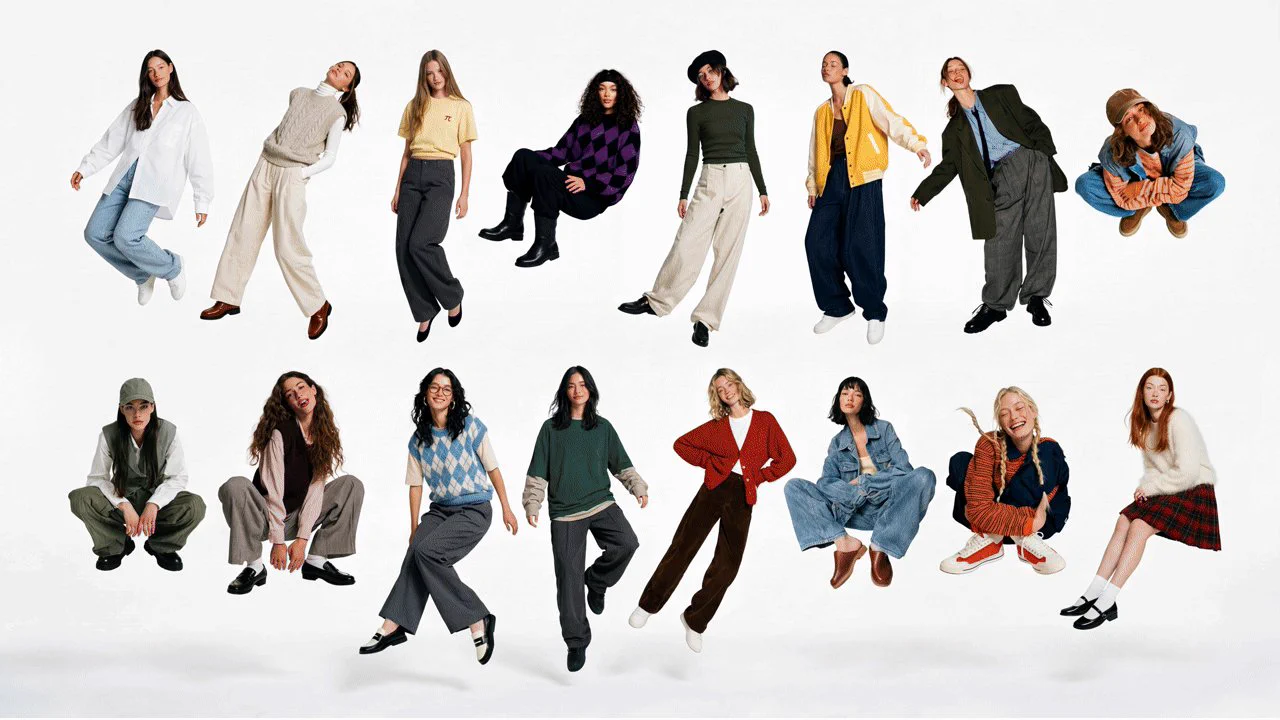
MiniMax 官方演示其图像生成能力支持在单次生成中输入 16 张参考图。官方称该能力适用于素材排布、空间构图、产品包装等场景,并配有视频演示。
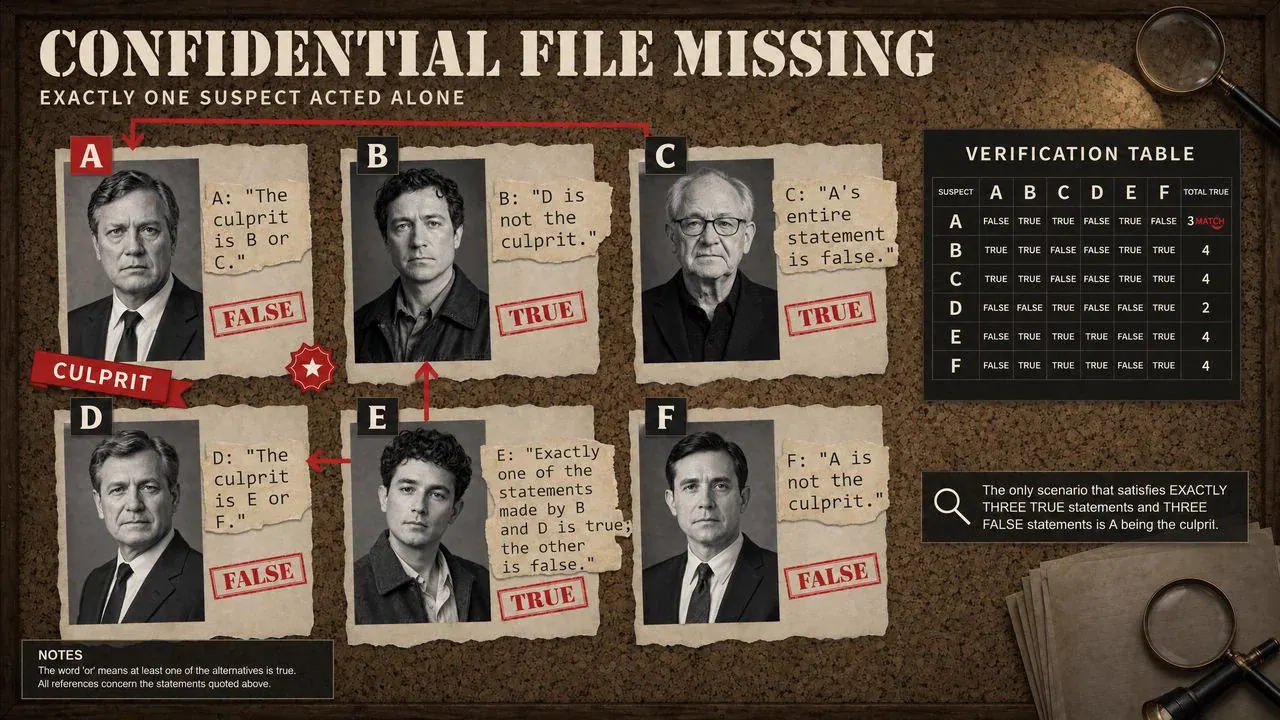
MiniMax 演示 H3-Image 将复杂信息转成图表和海报,并能把冗长案件叙述整合为单张证据板,把时间线、立场与证词分组、标注并连线。示例提示词要求为六名嫌疑人 A-F 的盗窃谜题生成 16:9 电影黑色侦探风证据板,标出每条陈述真假、高亮真凶,并附六种假设下真陈述数量的验证表。
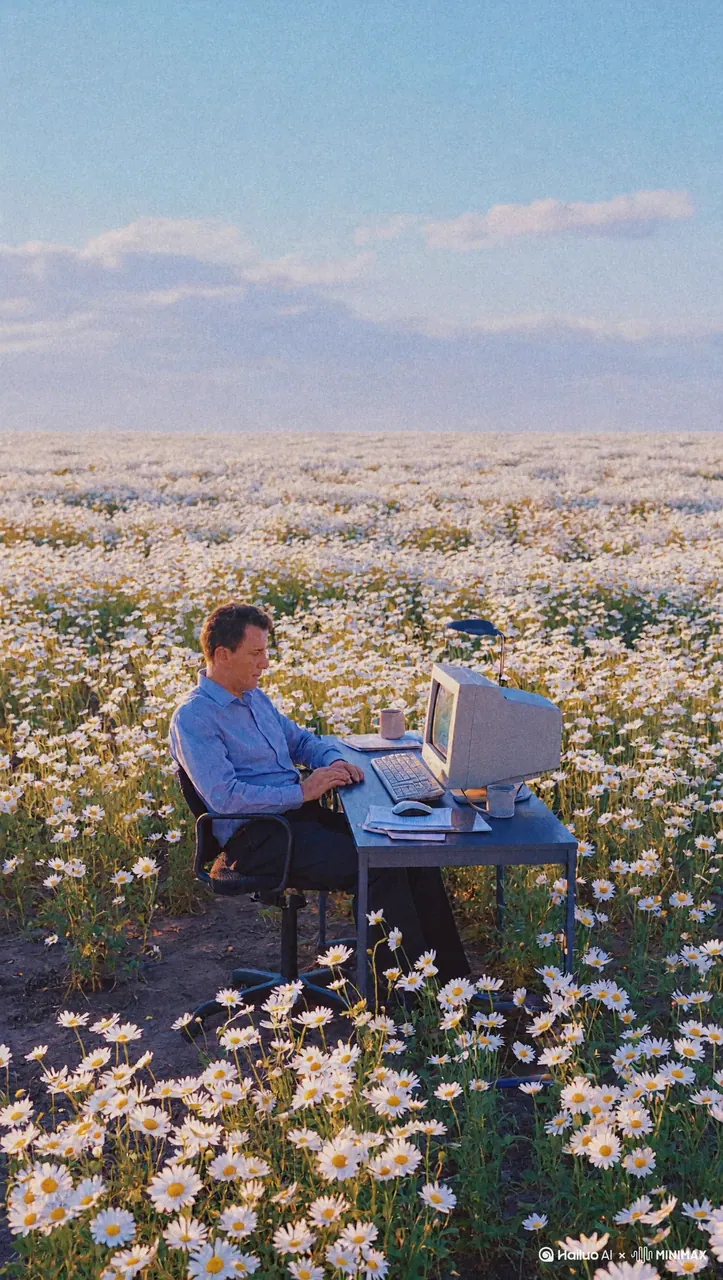
MiniMax 官方分享一条 Dreamcore 风格图像生成提示词,展示一名男子坐在无边雏菊花田中使用老式 CRT 电脑办公的超现实画面。提示词完整给出了场景描述、构图(竖版 9:16)、光线与 Kodak Portra 400 胶片质感等细节,图片水印显示由 Hailuo AI 与 MiniMax 生成。
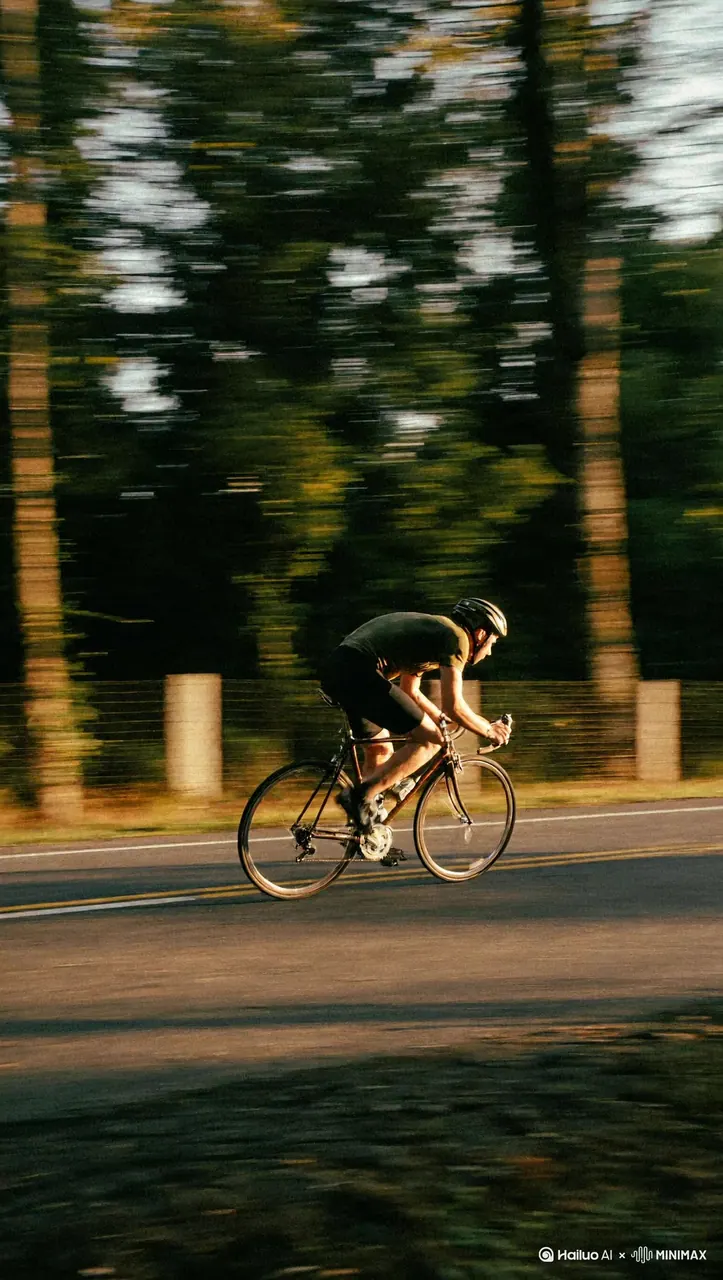
MiniMax 官方分享一条用于生成复古运动摄影效果的提示词,配图为 Hailuo AI 生成的骑行者慢门追随拍摄画面。提示词详细描述了慢快门追随摄影、方向性运动模糊、背景拉丝色带、低角度暖侧光和去饱和复古胶片色调等要素,并要求避免高速定格、数字速度线和商业广告式锐化。
作者通过 Claude 和 Seedance,将对 Blender 的学习时间和制作周期极大缩短,实现了快速的创意可视化。
作者趁 Fable 5.2 上线第一周智力最强的窗口,分享3个提示词,用于审查已有项目、找出受旧模型能力限制的低效实现并更新迭代。三个提示词分别让模型重新审视项目代码与文档并给出改动判断,扫描 GitHub 仓库和历史对话筛选值得发布、落 PR 或收尾的候选,再把筛出的前10%项目做成含代码动画或3张画面的交互式 HTML「项目进化图鉴」。
作者尝试用 AI 生成独特角度的'持械入宋'解读视频,数据不错,但随后遭遇抖音限流和短剧推广规则的挑战,探讨是否可以通过 AI + 分佣模式突破瓶颈。
MAX 2026 一周之内,Adobe 把入口开给 ChatGPT 与 Claude,模型选择器接入 Runway 与 Kling,云端算力改按积分计费;迪士尼联盟补上企业客户的 Firefly Foundry 封闭模型这一块。视频擦除按秒扣积分、规格锁在 1080p,本地 MCP 仍在 2027 年初私测计划内。
EnConvo 是一款功能全面的 macOS AI 助手,通过集成外接模型能力和全局快捷操作,实现系统级的 AI 自动化与多媒体创作支持。