发布全家桶应用 API
发布全家桶应用 API 在 DeepSeek App(含网页端)的对话服务中,联网搜索、文件输入、阅读链接、语音交互及安全等能力与模型推理相互配合,构成了用户熟悉的对话体验。今天,我们把这些能力开放给开发者:在原有 API 中开启对应参数,即可获得联网搜索、文件输入、阅读链接等对话功能,相关的工具调用与上下文拼接均由服务端完成
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
发布全家桶应用 API 在 DeepSeek App(含网页端)的对话服务中,联网搜索、文件输入、阅读链接、语音交互及安全等能力与模型推理相互配合,构成了用户熟悉的对话体验。今天,我们把这些能力开放给开发者:在原有 API 中开启对应参数,即可获得联网搜索、文件输入、阅读链接等对话功能,相关的工具调用与上下文拼接均由服务端完成
Tripo 官方宣布为 Runway 新支持的 3D 能力提供模型 Tripo H3.1。用户在 Runway 中可用文本或图像生成细节丰富的 3D 模型,也可上传自己的模型,选择任意角度作为后续图像或视频生成的参考,并将模型导出到其他 3D 工具。
Liquid AI 发布流式语音 tokenizer LiquidCodec,约 74M 参数,24 kHz 音频、12.5 Hz 帧、12 codebooks,权重已上架 Hugging Face。
Runway 用 LLM 重构内容审核系统,让政策制定与执行更贴合创作场景。相比两年前只能依赖第三方分类器按"血液""武器"等固定类别打分,新系统可基于自有政策判断,政策更新最快只需数分钟,并能区分奇幻战斗与真实暴力。Runway 称审核在两个方向上都更准确:误拦减少、漏拦也减少,但仍存在第三方模型自带审核、LLM 误判和上下文缺失等限制。
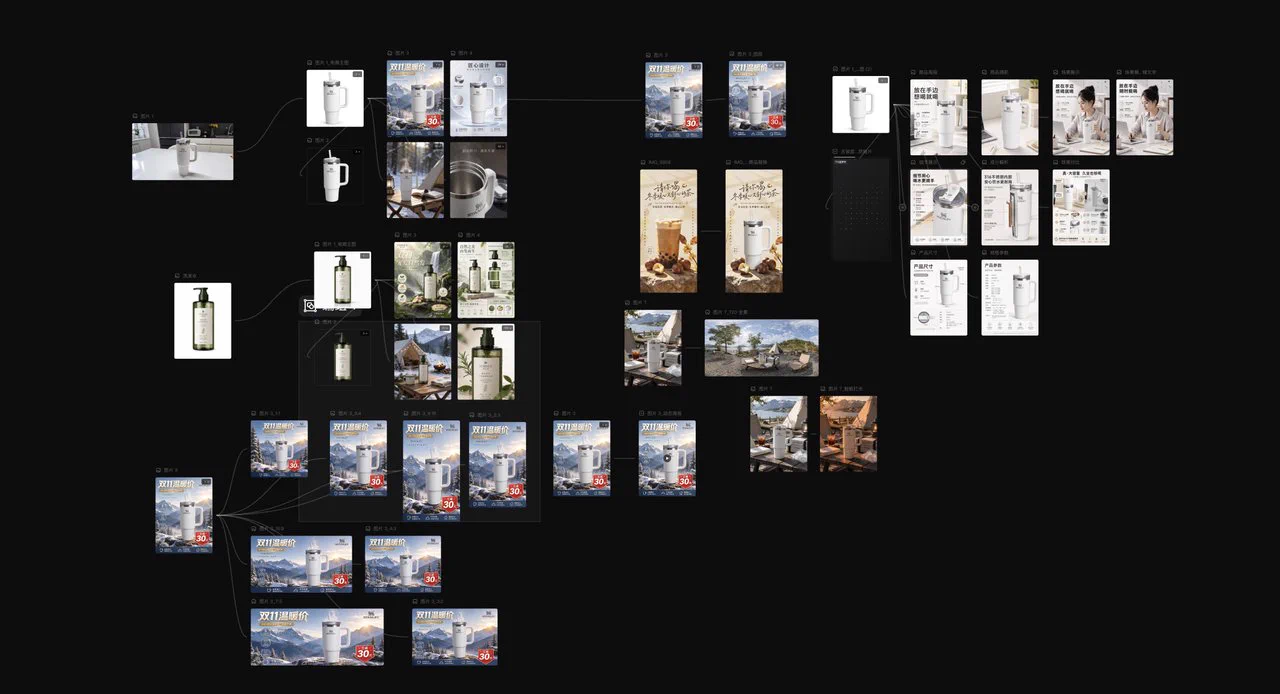
作者以一只保温杯为案例,实测即梦画布与 Seedream 5.5 如何从一张随手拍生成全套电商详情页物料和带货短剧,并对比 GPT Image 2.6
即梦这两周大大小小给自家画布做了20几个新功能,基本是把生图的所有常用功能包圆了
今天我们正式开放 ElevenLabs Marketplace。 它汇集了基于 ElevenLabs 构建的智能体与应用,覆盖医疗、金融服务、保险、教育、零售等多个领域。 https://elevenlabs.io/marketplace
fal 宣布 Seedream v5.5 现已可试用,提供三个模型入口。Text to Image、Edit 和 Layerize 分别对应 fal.ai 上 bytedance/seedream/v5.5 的 text-to-image、edit 和 layerize 页面。
fal 宣布 Seedream 5.5 正式上线,支持图像生成、编辑与转换。新能力包括多轮对话式编辑润色图像、直接在图像内编辑文字,以及将图像拆分为可编辑图层。
ElevenLabs 发布 Scribe v3 和 Scribe v3 Live 两款语音转文本模型,分别面向预录音频和低延迟实时场景,已通过 ElevenAPI 和 ElevenAgents 平台开放。
Adobe 在 MAX 2026 Sneaks 上揭晓十项研究预览,Project Link Up 把矢量设计的拖拽手势升级为带意图的语义融合,自动适配透视、比例与风格并保持结果可编辑。Link Up 尚未开放试用,现在能上手的是同场可玩的 Deep Brush 与 Hands On,官方时间表未给。
MiniMax 开源 SOTA 图像模型 H3-Image,原生 4K 分辨率,支持 16 张参考图,展现出接近人类水平的审美与世界理解能力,被称为多模态「源神」。
在 PixVerse 上试用 Seedream 5.5 https://app.pixverse.ai/?utm_source=Social&utm_medium=X
Anthropic 路演材料披露仅用3天完成 AMD MI355X 适配,改变的是上游算力采购的迁移成本账本,生成式工具的价目表还没有跟着动。创作者可记三个核对节点,2027年上半年首批1吉瓦落地、落地后的单位吞吐成本、多供应商采购是否扩散。
文章分享了即梦新推出的「动效工作室」功能,展示了如何通过输入需求即可生成知识科普、产品宣传等 vibe 视频,以及 Seedream 5.5 的多轮局部编辑和透明背景支持,为不使用 Claude 的用户提供了新的创作方案。
推文展示 AI 生成的搞笑视频,论证「AI 视频不可能有趣」的先入观念被打破,凸显了 AI 在幽默内容创作中的意外巧合。
用户质疑 AI 视频不好笑,作者转发搞笑视频回应,展示了 AI 视频在幽默表达上的潜力。
一位用户仅以一句话指令委托 Fable5.2 创作影视视频,最终呈现出高质量的视频内容,验证了 AI 在影视制作中的强大能力。
a16z 合伙人 Justine Moore 的 Fable 5.2 在 94 分钟内完成 1200×690 的 MS Paint 风格绘画,共用 11,066 笔刷和 261 种颜色,同时生成了配乐和创作说明。
Runway 于 11 月 11 日推出机器人模型 Praxis-1,将视频预训练知识用于真实机器人控制,模型以 Apache 2.0 许可证开放权重,权重和代码分别在 Hugging Face 和 GitHub 公开。
IT之家 11 月 12 日消息,字节火山引擎今日正式推出 Seedance 2.5 flash。 官方表示,这是 当前效果最接近 Seedance 2.5 的模型,生成速度提升一倍,价格更低 ,为批量内容生产提供了更具性价比的选择
火山引擎正式推出 Seedance 2.5 flash,生成速度较 Seedance 2.5 提升一倍,720P 下文生视频、图生视频价格约 0.99元/秒,降低约34%。
Runway 开源 27B 世界动作模型 Praxis-1:登顶机器人权威榜单,全面支持 Apache 2.0 商业开源 · · Nov 12, 2026 人工智能在具身智能领域的竞争迎来了又一个里程碑
IT之家 11 月 12 日消息,谷歌昨日宣布推出 Gemini Decisions API 快速多模态决策,由全新 Gemini Decision 1 模型驱动。该 API 可在 1 次快速处理过程中,对文本、图像、视频和 PDF 内容进行至多 1000 项是非判断、选项选择和标准评估
Google 推出 Gemini Decisions API,由新模型 Gemini Decision 1 驱动,可在 150-250ms 端到端延迟内对文本、图像、音频、视频和 PDF(最多 256K tokens)一次性评估最多 1000 个是/否、多选和评分题。
vLLM-Omni 团队将 MiniMax 开源权重图像生成与编辑模型 H3-Image 带到 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 生成中位延迟 0.866 秒,比 GB200 快 2.21 倍;吞吐配置(SP1×DP4)达 6,115 张/小时。
Runway 宣布世界动作模型 Praxis-1 以 Apache 2.0 开放权重面向所有人开放。该模型为 27B 参数 MoE 扩散 Transformer,同时预测视频与动作,在 NVIDIA RoboLab-120 榜单以 46.2% 成功率居首
Luma AI 宣布 Character Swap & Insert 功能现已上线 Luma,可对已有视频进行角色替换与插入。演示展示了在同一镜头内更换演员、更换汽车、加入一只狗或移除人物等客户常见修改需求。
ElevenLabs 在 Summit NYC 上公布五项智能体相关发布:Fine-tuning 允许企业未来几个月用自有数据持续微调其语音模型及开源 LLM。
MiniMax 官方演示其新的开放权重模型 H3 Image 的电商与广告创意用法:从草图或产品图出发,一次生成棚拍到生活方式广告等每个场景都保持一致的画面