2026-10-21
8GB 显存即可运行:5.6B 图像生成模型 FLUX 3 Image Klein 发布
IT之家 10 月 21 日消息,视觉人工智能实验室 Black Forest Labs 当地时间本月 15 日以开放权重的形式发布了 FLUX 3 Image Klein 图像生成模型。 FLUX 3 Image Klein 拥有 5.6B 的参数,针对消费级 GPU 进行了优化
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
IT之家 10 月 21 日消息,视觉人工智能实验室 Black Forest Labs 当地时间本月 15 日以开放权重的形式发布了 FLUX 3 Image Klein 图像生成模型。 FLUX 3 Image Klein 拥有 5.6B 的参数,针对消费级 GPU 进行了优化
2026 年 10 月,法国人工智能团队 Mistral 发布了新一代语音模型家族 Voxtral 3。
Mistral AI 发布 Voxtral 3,包含 3 个转录模型、1 个 TTS 模型和基于 LiveKit 的 Voice Agent SDK,全部 4 个模型在 Mistral API 上开放公开预览。
ElevenLabs 发布 Eleven Realtime Max 和 Mini 两个语音到语音模型。Max 在 Big Bench Audio 上得分 98.8%,起播延迟 0.57s;Mini 面向低成本自然对话场景优化。两个模型均已在 ElevenAgents 平台和 API 上提供。
IT之家 10 月 21 日消息,Spotify 当地时间周二发布公告称,过去一年,平台已从用户推荐流中移除超过 5000 万首被认定为 AI 生成的低质垃圾或垃圾流量歌曲,同时还对推荐系统作出了调整,优先展示真人创作者的音乐作品。 Spotify 表示:“平台编辑团队执行同样标准,不会把被判定为劣质 AI 垃圾内容或垃圾灌水曲目纳入推荐流中
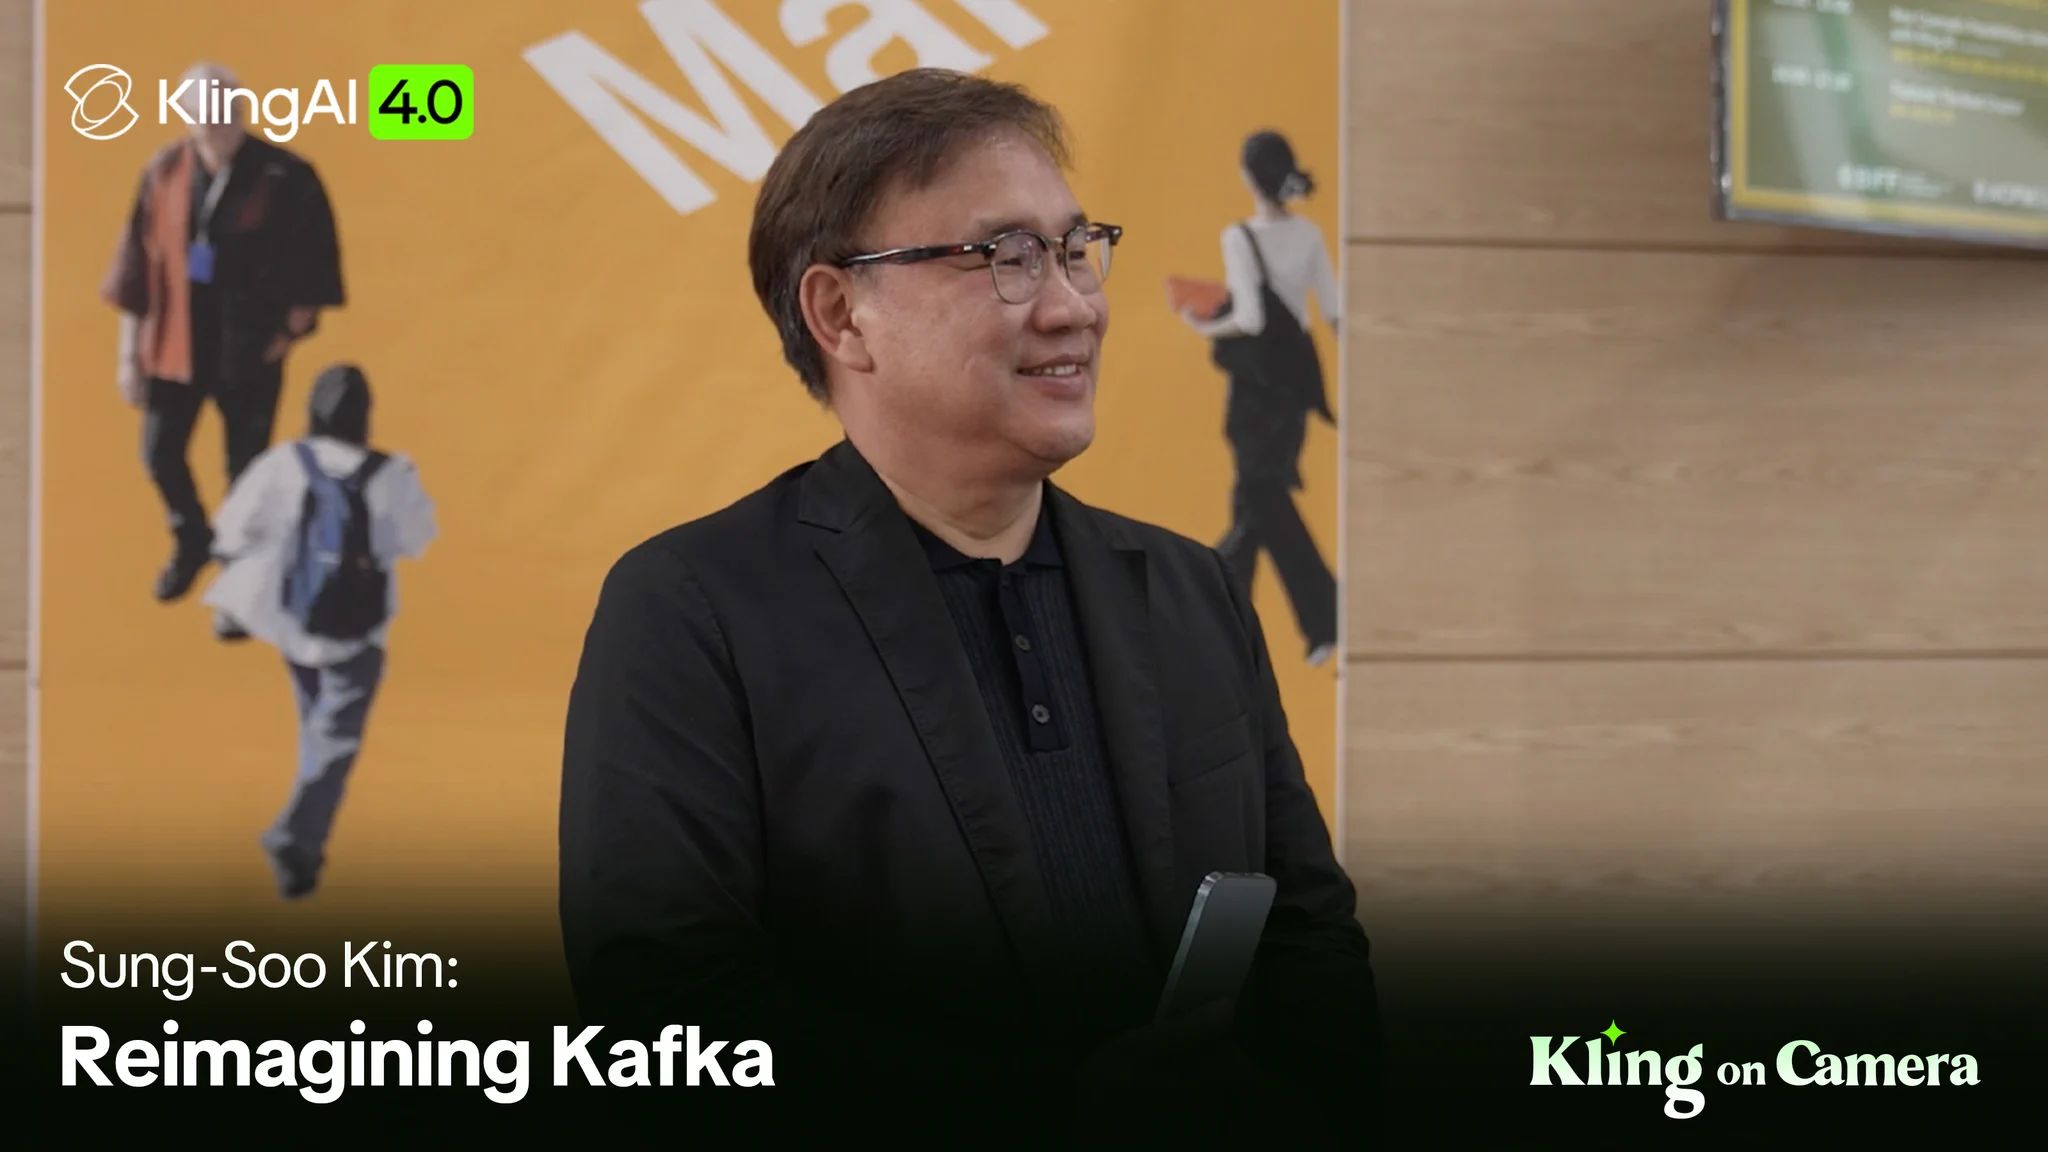
拥挤的地铁车厢。乘客与一只巨型虫子相撞。这是韩国导演金成洙多年来一直想搬上银幕的卡夫卡式场景。 观看金成洙分享他首次使用AI制片的经历,并解释可灵4.0如何让这个“不可能”的镜头成为可能。
OpenAI 开发者账号宣布 API 现已可选 12 小时 prompt 缓存,持续运行的智能体可在请求间隔数小时的情况下继续以更低的缓存输入费率复用指令、工具和上下文。Tibo 补充称,Codex 与 Work 中已登录用户的缓存会永久保留,返回旧对话或数小时后恢复会话保证命中缓存,且无额外惩罚。
Spotify年内已从推荐系统移除超5000万首AI垃圾歌曲 · · Oct 21, 2026 Spotify于2026年10月宣布,今年迄今已从用户推荐系统中移除超过5000万首人工智能生成的垃圾歌曲,并彻底删除了超过7500万首严重违规的垃圾曲目
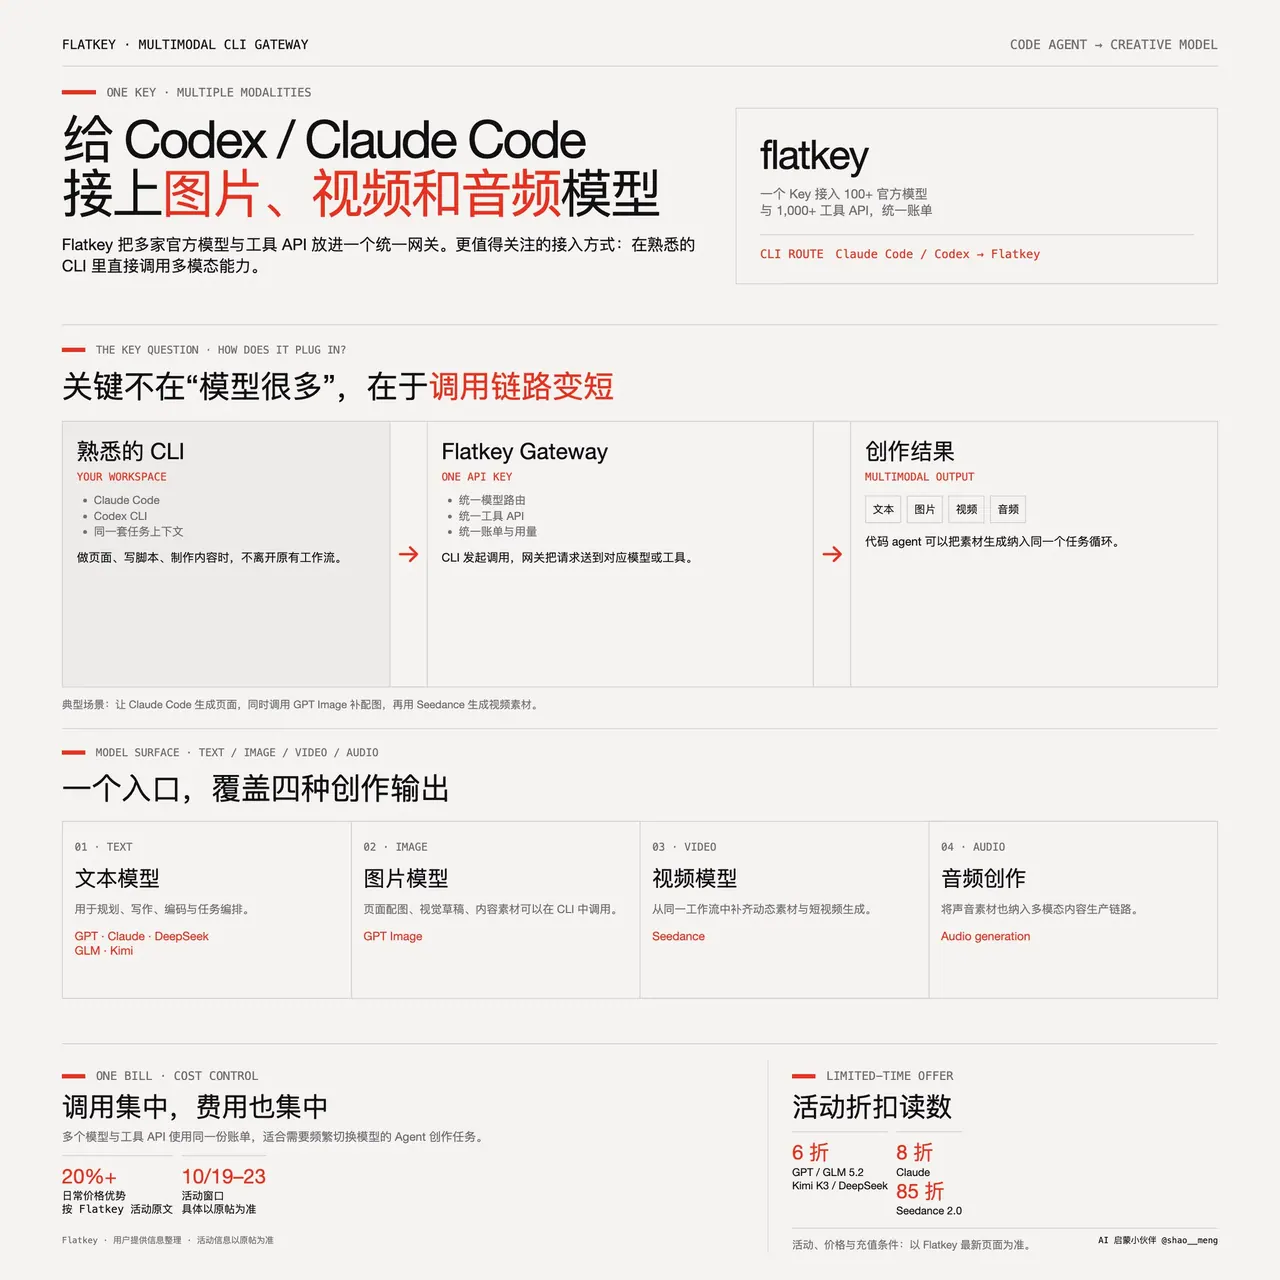
Flatkey 推出统一 AI API 网关,通过 CLI 让 Codex 和 Claude Code 调用 GPT、Claude、DeepSeek、GLM、Kimi 等文本模型及 GPT Image、Seedance 等图片视频模型。
ComfyUI 宣布支持 Hao AI Lab 的 FastH3 OmniRef,这是 MiniMax H3 的蒸馏版本,可进行多模态参考视频生成,能在本地硬件上运行。官方称其在质量与速度之间取得较好平衡,并开放了权重与云端入口。
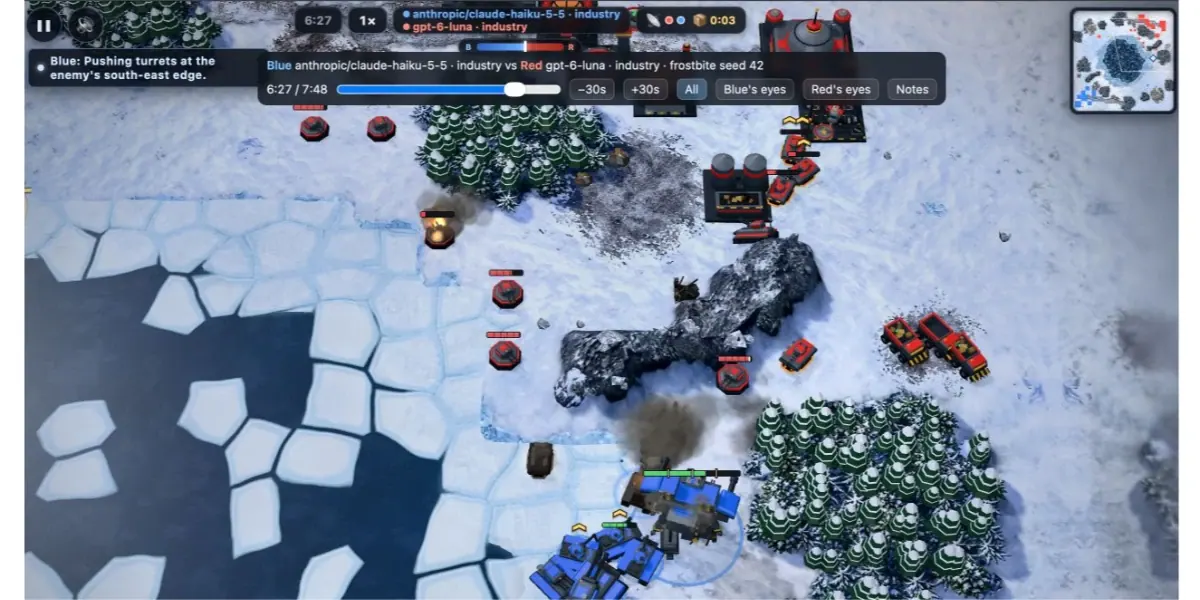
Simon Willison 记录了 Battle Drones 的开发过程:他通过 12 轮氛围编程,借助 Claude Code 打造出一款完整可玩的 3D 即时战略游戏,其中包含各具特色的 AI、基于音频的本地多人游戏,以及 LLM 智能体对战。
ElevenLabs 于 10 月 20 日发布两款语音到语音模型 Eleven Realtime。
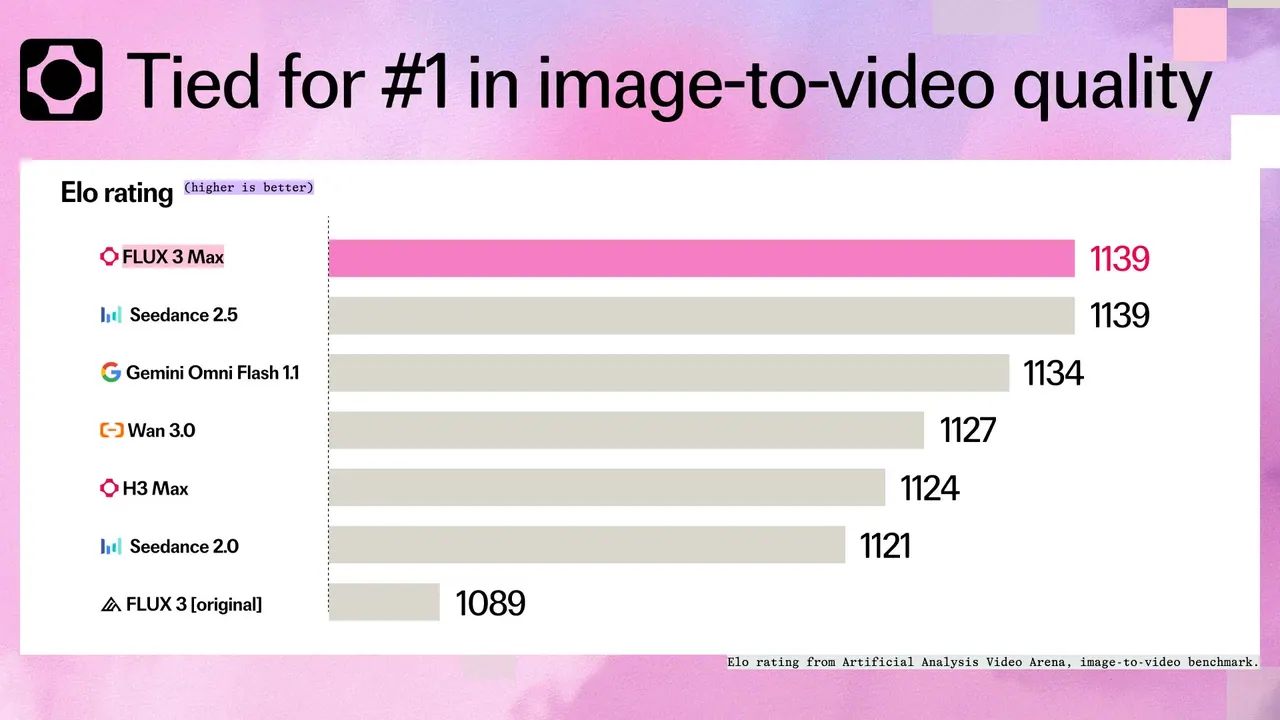
fal 发布与 Black Forest Labs 合作后训练的视频模型 FLUX 3 Max,在第三方独立人类偏好评测中获 1139 Elo,与 Seedance 2.5 并列图生视频质量第一梯队。该模型约 12 秒生成一段 10 秒 720/768p 视频,未来三周降价 75%,后续还将继续后训练改进。
Runway 携 Runway Creative 加入 Claude Marketplace,符合条件的企业客户可用现有 Anthropic 承诺额度的一部分购买该平台。
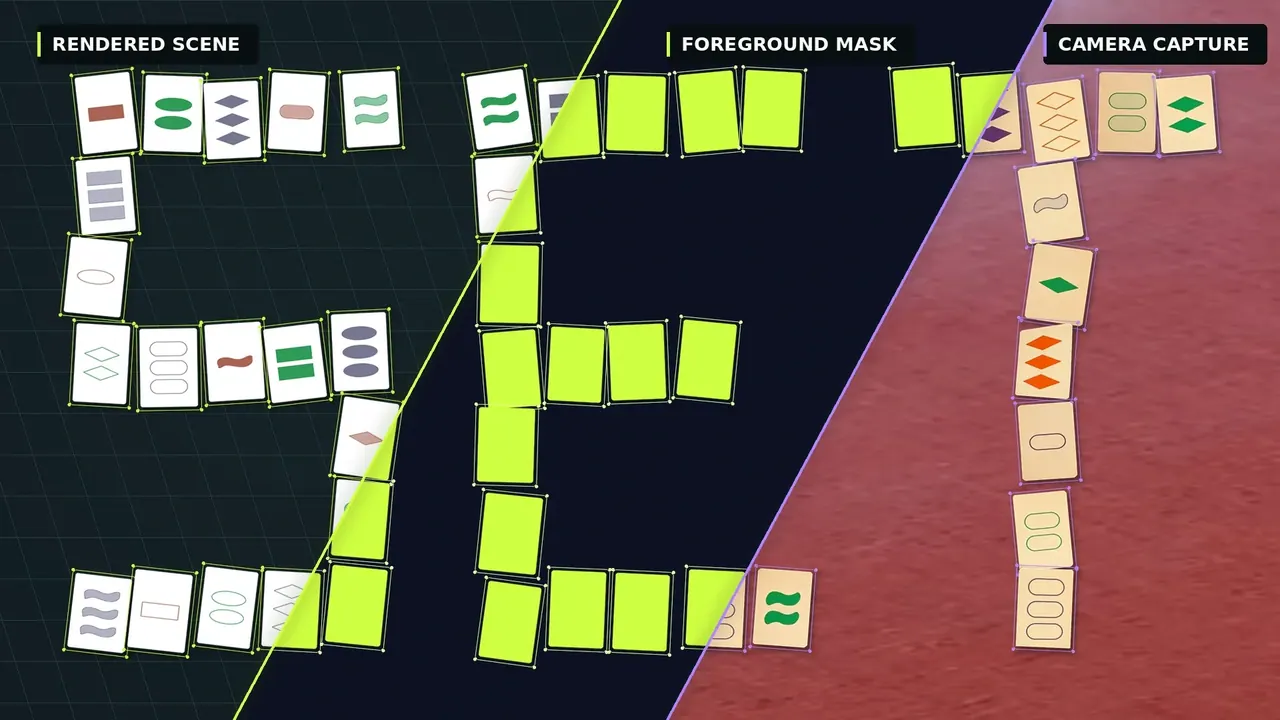
在程序生成的 SET 卡牌图像上训练冻结的 DINOv3 特征,可在检测、旋转框、角点检测和分割任务中实现向真实照片的强劲零样本迁移,并对各类失败模式进行了详细分析。
ElevenLabs 发布 Eleven Realtime,一类新的语音到语音(Speech to Speech)模型。官方称语音智能体通常需要在快速回复和准确回答之间取舍,Eleven Realtime 两者兼顾,能在半秒内开始说话,并答对口语推理问题。
MiniMax 发布 M3.1 Flash,在 Agents' Last Exam 中以 29.6% 的得分成为国模第一,同时在 Coding、网络安全、Computer Use 等领域跻身全球第一梯队,并以大幅降低的成本(综合成本降至 M3 的 30%)提供与 V4.1 Flash 相当的性价比。
蚂蚁百灵开源 Ming-3.0 语音系列五款模型,覆盖语音合成、音频理解与对话、语音识别,实测在多说话人长对话分析、英文发音鲁棒性、语音推理及识别错误率等基准上均达开放权重模型前列。
IT之家 10 月 20 日消息,小米旗下“米家洗衣机健康洗双筒 1KG”现已在京东发售,定价为 1299 元。 该机占地面积小于 0.2m²,净重为 16kg,可放置在卫生间台面或滚筒洗衣机上方。设备顶部配有防烫双层桶盖,底部设有防滑底脚。总洗涤容量为 1KG,分为两个 0.5KG 的小筒,水路系统采用双筒独立进排水设计,管路全程分离
本文汇总了近期发布的多个 AI 项目,包括中国电信的意图理解模型 Xing4.0-29B-Intent、MiniMax 的高速模型服务 M3.1 Flash、NVIDIA 的机器人仿真平台 Isaac Lab 3.0,以及其他涉及视频理解、模型记忆和训练优化的技术进展。
加州大学圣塔芭芭拉分校等机构提出 WorldMemArena 基准,将多模态 Agent 记忆评测从静态问答推进到「观察—行动—环境反馈」的动态闭环,揭示高召回率不等于高任务成功率,指出记忆修订与跨模态推理是当前核心短板。
AI 日报汇总了腾讯开放元宝搜索 API、MiniMax 发布 M3.1Flash、蚂蚁百灵开源 Ming-3.0 语音模型、ChatGPT 浏览器扩展升级、奇瑞发布垂域大模型、Gartner 预警 AI 基建投资风险、Strata 本地部署工具升级及 OpenAI 加速融资等八大行业动态。
符号矩阵 Lab 整理的 2026 年 10 月 18 日 AI 论文简报,涵盖大模型推理、多模态、视觉导航、3D 视觉及科研工具等沿沿。
iRTE 2026 实时智能大会将举办「开发者工具专场」,汇聚 Kimi、Qwen、MiniMax 等一线实践者,探讨 AI Coding、Agent 开发及人机协作的新范式。
通往 AGI 之路发布抖音 AI 夜校第二节直播预告,邀请 AIGC 导演讲解首尾帧生成与镜头控制技巧,教学如何将静态图片转为高清动态视频素材。
据 The Decoder 报道,可灵(Kling)发布 Kling 4.0 视频模型,单条视频最长可生成 30 秒,提示词理解扩展到 8,000 tokens。新模型支持双声道立体声音频和超过十种语言的唇形同步,同时推出更轻量的 Flash 版本。
很多自媒体创作者或设计人员在用 AI 工具生成精美图片后,直接把一张原图分发到小红书、微信公众号、B 站或各类海外社交平台。发布完成后打开手机端查看,
AI 图像生成技术在过去两年中完成了从“娱乐级盲盒抽卡”向“工业级生产辅助”的转变。对于商业视觉设计团队、广告创意公司与电商美工而言,
很多创作者在使用 Runway 制作 AI 视频短片时,多半陷入一种极其昂贵且痛苦的“抽卡循环”,
Anthropic 9 月 22 日发布的 Opus 5.5 这几天被叫成了「最强视频生成模型」,因为它做了一批看起来像视频生成的东西,