2026-10-23
MiniMax 开放 M3.1 Flash 权重,Together AI 同步提供托管服务
MiniMax 官方宣布 M3.1 Flash 开放权重,Together AI 作为 day-0 合作伙伴提供全托管服务
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
MiniMax 官方宣布 M3.1 Flash 开放权重,Together AI 作为 day-0 合作伙伴提供全托管服务
我们正与 Inferact 合作,推进 MiniMax 模型的生产推理,相关工程改进已回馈至 @vllm_project。 感谢 Inferact 团队从第一天起就支持 M3.1 Flash 的生产部署。期待共同建设!
从推理到 RL,第一天就绪。🐰 感谢 SGLang 背后的团队,以及 Miles @sgl_project 与 @NVIDIAAI 和 @AMD,对 MiniMax M3.1 Flash 的支持。合作愉快!
音乐出版商 Reservoir 起诉 Suno 与 Anthropic,指控未经授权用版权歌曲训练 AI · · Oct 23, 2026 31.8k 又一场关于"AI 吃进去的歌到底归谁"的官司,在10月21日砸向了两家头部人工智能公司
MiniMax 感谢 NVIDIA NeMo 团队为 MiniMax-M3.1-Flash 提供 day-0 微调支持。引用内容提到 Space Bunny 此前已处理 200T+ tokens,现已开放权重,NeMo-AutoModel 支持 FSDP2、专家、流水线和上下文并行,可扩展到 128 GPUs,NVFP4 checkpoint 可直接加载
IT之家 10 月 23 日消息,MiniMax 稀宇科技今日宣布 开源 MiniMax M3.1 Flash 的模型权重 ,总参数 428B,激活参数 23B。 相较于上一代 M3 模型,M3.1 Flash 的模型能力实现了全面提升
MiniMax 宣布开放 M3.1 Flash 权重,总参数量为 428B,每 token 激活 23B,并提供 Hugging Face 和 ModelScope 下载。该模型在智能体任务、编程和网络安全方面表现出色,并采用稀疏注意力等技术提高推理效率。
MiniMax 宣布 M3.1 Flash 权重公开,总参数 428B、每 token 激活 23B,提供 Hugging Face 和 ModelScope 下载。
IT之家 10 月 23 日消息,10 月 16 日,商务部、科技部就 修订《中国禁止出口限制出口技术目录》公开征求意见 。 其中,人工智能领域包括 大模型、智能体、算力集群、信息处理 相关 23 项技术;对已通过开源、发表学术论文等方式进入公共领域的技术,不纳入管理范围
MiniMax 宣布开源 M3.1 Flash 模型权重,该模型通过全模型稀疏注意力、QAT 和 Power-aware scheduling 优化,实现了显著的性能提升和推理效率,上线 72 小时内处理超过 100 万亿 Token,并得到多家芯片和云服务平台的广泛支持。
MiniMax 开源 M3.1 Flash 模型权重,总参数 428B,激活参数 23B,上线 72 小时内真实用户处理 Token 超过 100 万亿。
vLLM 在发布当天即支持 MiniMax-M3 系列新模型 MiniMax-M3.1-Flash,覆盖 NVIDIA Blackwell、Rubin 和 AMD MI350 系列 GPU。
“IT早报”时间,大家好,现在是 2026 年 10 月 23 日星期五,今天的重要科技资讯有: 1. 陕西神木市交管大队回应问界汽车碰撞起火事故:灯柱被烧短路、变色,目前正喷漆 近日,一辆问界汽车在陕西榆林神木市一路口处发生碰撞起火。据新京报报道,陕西神木市交管大队回应了“问界汽车撞击交通灯柱后起火”事件
Canva 发布自研图像生成模型 Canva Craft,采用先规划设计再生成图像的两阶段架构,支持最高 2K 分辨率和 30 多种宽高比。模型基于平台数百万人工模板训练,目前在 Design Arena 排行榜位列第四,已向全球所有用户开放,未来还将推出 Craft-fast 和 Craft-ultrafast 版本并支持通过 MCP 接入 AI 智能体。
你一直在用 Suno。但你这样用过它吗?🧵
fal 发布与 bfl_ai 合作训练的最新后训练视频模型 FLUX 3 Max,生成 10 秒 720/768p 视频仅需 12.45 秒,而 Seedance 2.5 需 277.8 秒,两者在第三方评测中 Elo 均为 1139。该模型在第三方图生视频质量榜并列第一,未来三周降价 75%。
分享一下你本月创作的歌曲 👇
Claix 为 AI 智能体提供统一的类型化端点,用于读取 Postgres 或 Supabase 数据库,并负责查询生成、权限控制和请求追踪,同时让开发者掌控智能体逻辑。
Ideogram 发布首个矢量模型 Vector 1.0,可由文本提示生成带平滑渐变和清晰排版的干净、可编辑 SVG,也能把任意图像转为可缩放的详细矢量。生成的 SVG 各组件为独立图层,用户可旋转和移动;目前已上线 Ideogram 及其 API。
Ideogram Vector 现已在 fal 上线。它可从文本生成可编辑 SVG,将已有图像转换为矢量图形,并支持用参考图像进行引导生成。
Spotify 在 Q3 财报电话会上解释其 AI 战略,联席 CEO Gustav Söderström 称 Spotify 是少数能在智能体时代受益的品类,目标是成为各种 Agent 调用的媒体服务。
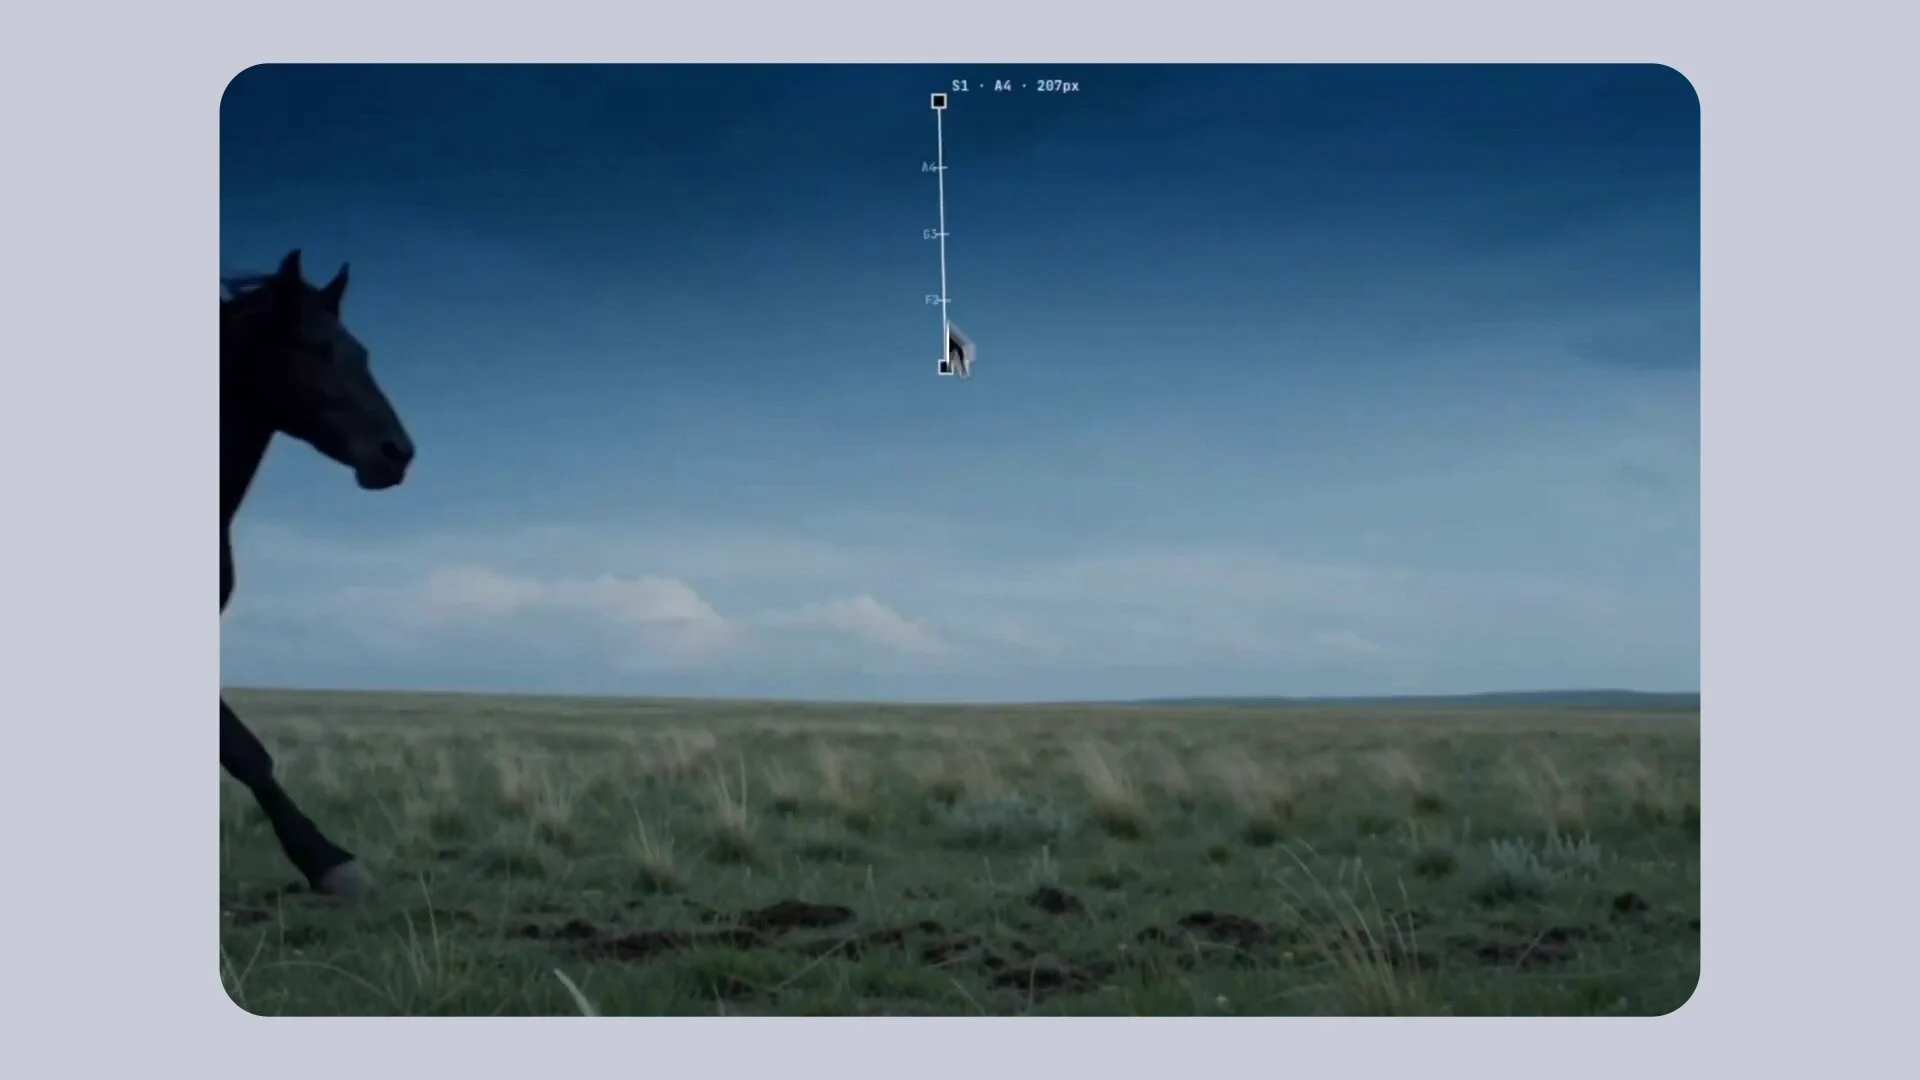
让你的视频自己创作配乐 🎶 在 @GeminiApp 中使用 Canvas,Gemini 4 Argon 打造了一个工具,可在实时视频上追踪音阶线条——每当有运动穿过屏幕时便触发音符。
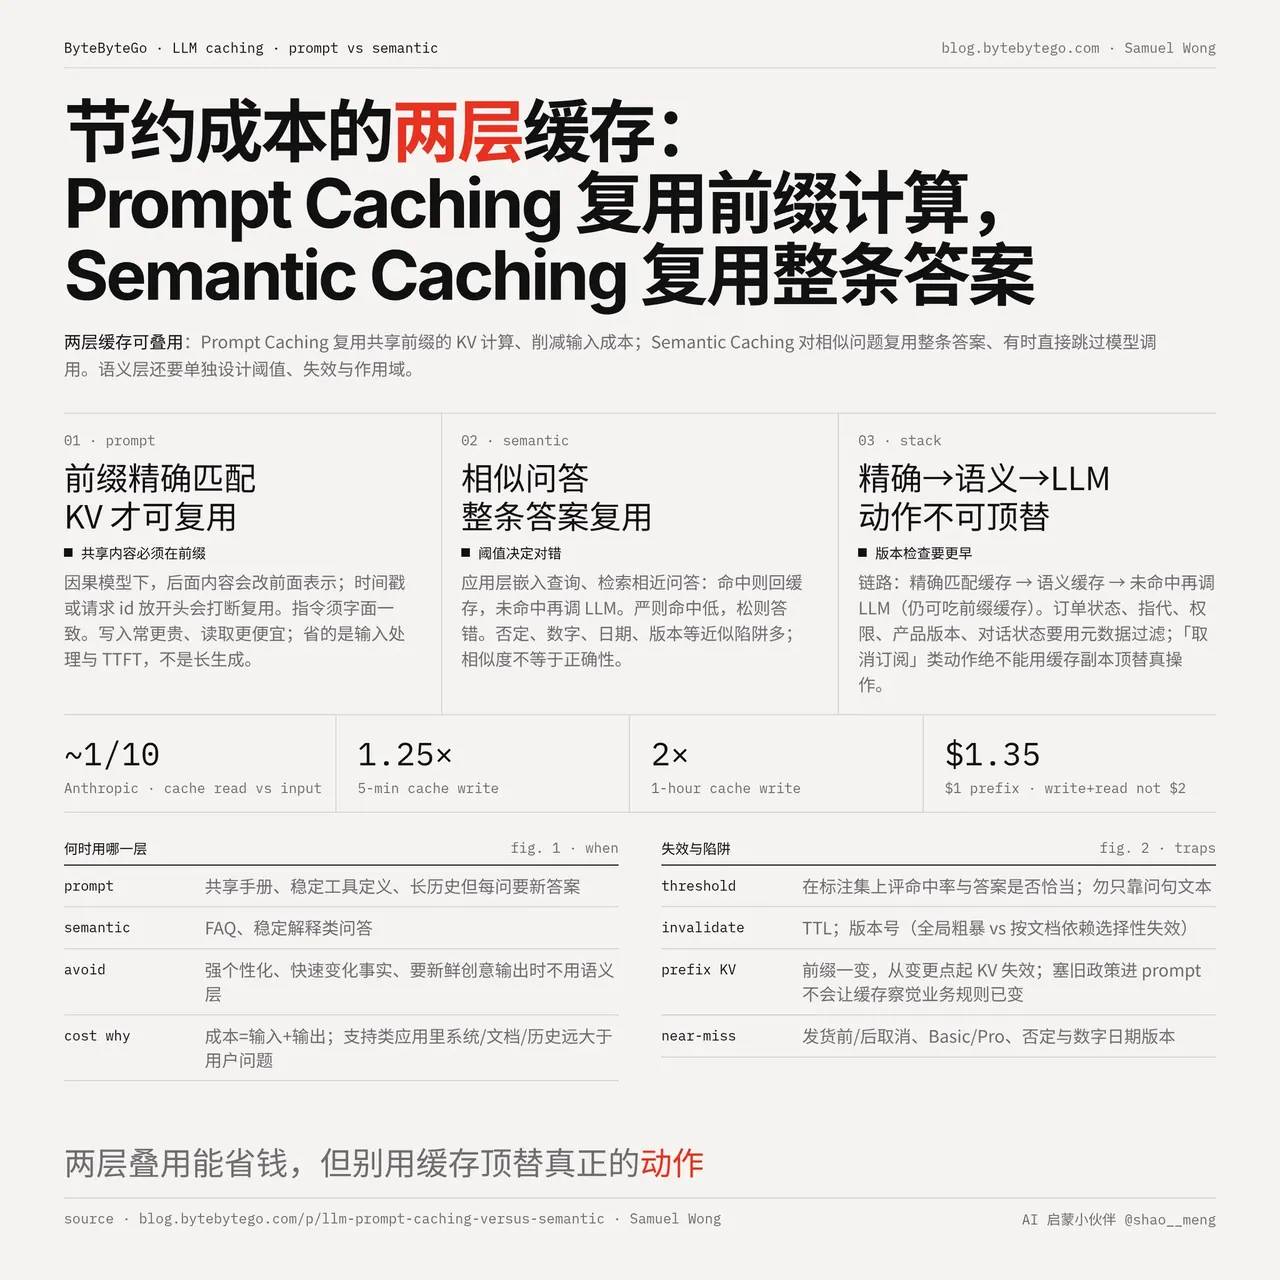
ByteByteGo 作者 Samuel Wong 撰文讲解 LLM 应用中两类缓存如何分工并叠加使用:Prompt Caching 复用共享前缀的 KV 计算以降低输入成本,Semantic Caching 复用语义相近问题的整条答案,可完全跳过模型调用。
2026 年 10 月,法国人工智能团队 Mistral 发布了新一代语音模型家族 Voxtral 3。
很多自媒体创作者或设计人员在用 AI 工具生成精美图片后,直接把一张原图分发到小红书、微信公众号、B 站或各类海外社交平台。发布完成后打开手机端查看,
AI 图像生成技术在过去两年中完成了从“娱乐级盲盒抽卡”向“工业级生产辅助”的转变。对于商业视觉设计团队、广告创意公司与电商美工而言,
很多创作者在使用 Runway 制作 AI 视频短片时,多半陷入一种极其昂贵且痛苦的“抽卡循环”,
Anthropic 9 月 22 日发布的 Opus 5.5 这几天被叫成了「最强视频生成模型」,因为它做了一批看起来像视频生成的东西,
Suno 3 月 26 日发布 v5.5,官方说这是「迄今为止最有表现力的模型」。这一版新加的三样功能都围着用户自己转,克隆你的歌声,用你自己的曲子训练模型,