DeepSeek-V4.1-Flash 发布:552B MoE 多模态模型主打 KV cache 压缩
DeepSeek 发布 DeepSeek-V4.1-Flash,一个 552B 参数的多模态 MoE 模型,支持最长 100 万 token 上下文,模型权重已在 Hugging Face 开放。
第 2 页
DeepSeek 发布 DeepSeek-V4.1-Flash,一个 552B 参数的多模态 MoE 模型,支持最长 100 万 token 上下文,模型权重已在 Hugging Face 开放。
OpenRouter 梳理其目录中的 DeepSeek V4 系列图像输入支持情况:V4.1 Flash 原生读图(2026年9月10日上线,$0.15/$0.60 每百万 token)。
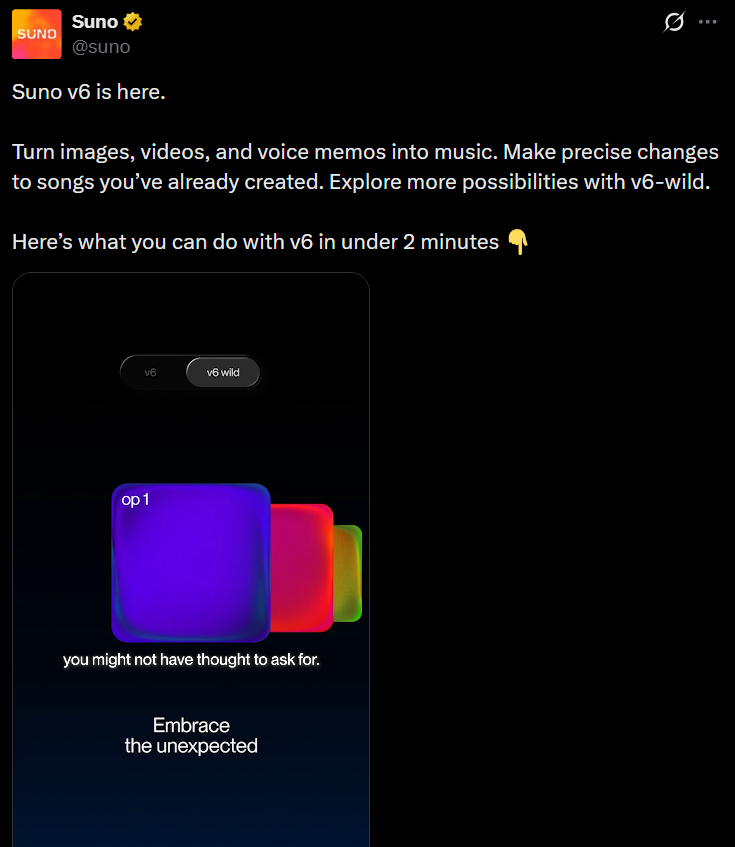
Suno 发布 v6 音乐模型,推出 v6、v6-wild、v6-mini 三个版本 — 点击查看完整日报
据《案件聚焦》节目公众号,近日上海市浦东新区人民法院宣判了上海市首例涉 AI 声音仿冒不正当竞争纠纷案。米哈游公司于 2025 年发现,一款 AI 变声软件提供了《原神》63 款角色的声音资源包,供用户付费变声使用,同时该软件还大量使用《原神》角色图片。米哈游随后将这款软件的运营公司告上法庭,称被告提供的变声服务会让用
AI 音乐生成平台 Suno 正式推出全新一代模型家族——Suno v6。这是 Suno 迄今为止最大的升级,也是其与华纳音乐集团(Warner Music Group)、BMG 及 Believe 等音乐产业合作伙伴共同开发的首个模型系列。官方称,v6模型更快、更富表现力、音质更高,并赋予创作者前所未有的精准控制力。
深度求索今日正式发布了全新模型结构系列中的最小尺寸成员——DeepSeek V4.1Flash。作为一款具备原生多模态视觉理解能力的轻量化模型,其设计初衷旨在实现更高的能力上限、更快的推理速度、更大的吞吐量,并具备向更大参数模型扩展的潜力。在核心架构方面,DeepSeek V4.1Flash 采用了552B 参数的 M
语言不通造成的影视剧观看违和感即将成为历史。当地时间9月9日,亚马逊通过新闻稿正式宣布,旗下流媒体平台Prime Video全面上线全新的AI口型同步功能。该技术能够巧妙地将演员的嘴部动作与真人配音的音轨进行精准对齐,彻底解决过去跨语言配音时画面与声音脱节的痛点。作为该功能的全球首发落地项目,目前这项技术率先支持德国热
IT之家 9 月 10 日消息,当地时间 9 日,亚马逊通过新闻稿宣布 Prime Video 上线 AI 口型同步功能,可以让 演员的嘴部动作与“真人配音”音轨对齐 。目前,该功能仅支持德国剧集《贵族高中:我们之间的鸿沟》的英语配音版,未来还将扩展至更多作品
Meme Fest 亮点来了:蒙娜丽莎开始说唱,一片菠菜叶长出了脸,一只狗在亲戚上门时假装刷手机……创作者的脑洞没有上限。
作者发布 GPT Image 2.5 提示词与图像编辑完全指南,主张 AI 图像生成正从文生图技巧转向局部编辑、多图合成、角色一致性与工程交付的工作流,并拆解官方指南的 8 大心法与 22 个命名工作流。
IT之家 9 月 10 日消息,深度求索今日正式发布 DeepSeek V4.1 Flash 模型 。这是其全新模型结构系列中的最小尺寸的模型,具备原生多模态视觉理解能力。 新模型结构的设计初衷是:能力上限更高、推理速度更快、吞吐更大、可扩展到更大参数模型
DeepSeek 正式发布 V4.1 Flash,全新 Causal-Encoder-Decoder 结构的 552B 参数 MoE 模型,输入激活 8B、输出激活 16B,具备原生多模态视觉理解,基准测试超越包括 DeepSeek V4 Pro 在内的旗舰模型。
Suno 发布 v6 模型,可将图片、视频和语音备忘录转化为音乐,并对已创建的歌曲进行精确修改。同时提供 v6-wild 版本供探索更多可能性,官方附有 2 分钟以内的功能演示视频。
DeepSeek-V4.1-Flash 发布 今天,我们正式发布 DeepSeek-V4.1-Flash 模型。这是我们全新模型结构系列中的最小尺寸的模型,具备原生多模态视觉理解能力。新模型结构的设计初衷是:能力上限更高、推理速度更快、吞吐更大、可扩展到更大参数模型
作者提供了一个对比仓库,展示了在相同提示词下 GPT Image 2.5 与 2.0 版本的生成效果差异。
OpenAI 推出 ChatGPT Images 2.5 提升生成速度与编辑精度,并公布对 Navier‑Stokes 千禧年难题的构造性解法,展示 AI 在图像和高阶数学领域的最新突破。
花叔用 800 字故事让视频 Agent「够搭」自动拆成 17 场戏、生成设定图和视频片段,拼出 5 分钟成片,并验证了成片后局部修改不推倒重来的能力,认为 AI 视频创作进入更可控的「单反级交付时代」。
SkyProduction(天工工作台)联合昆仑万维推出 MiniMax H3 模型限免活动,9 月 9 日会员可免费无限使用,9 月 10-14 日新开会员或充值积分可获赠限免天数,活动旨在降低短剧、漫剧等创作者的试错成本。
ChatGPT 发布了 Images 2.5 版本,主打更快的生成速度、更高的图像保真度和基于评论的编辑功能。
OpenAI 发布 ChatGPT Images 2.5 图像模型 — 点击查看完整日报
OpenAI 推出 API 新图像模型 GPT-Image-2.5 Flare 和 Sunburst,主要改进包括更锐利的细节、更强的风格遵循,以及更多对图像编辑的控制。
OpenAI 发布 ChatGPT Images 2.5 图像模型,生成延迟比 Images 2.0 降低最多 50%,细节、编辑精度、参考照片保真度和多轮编辑一致性均有提升。
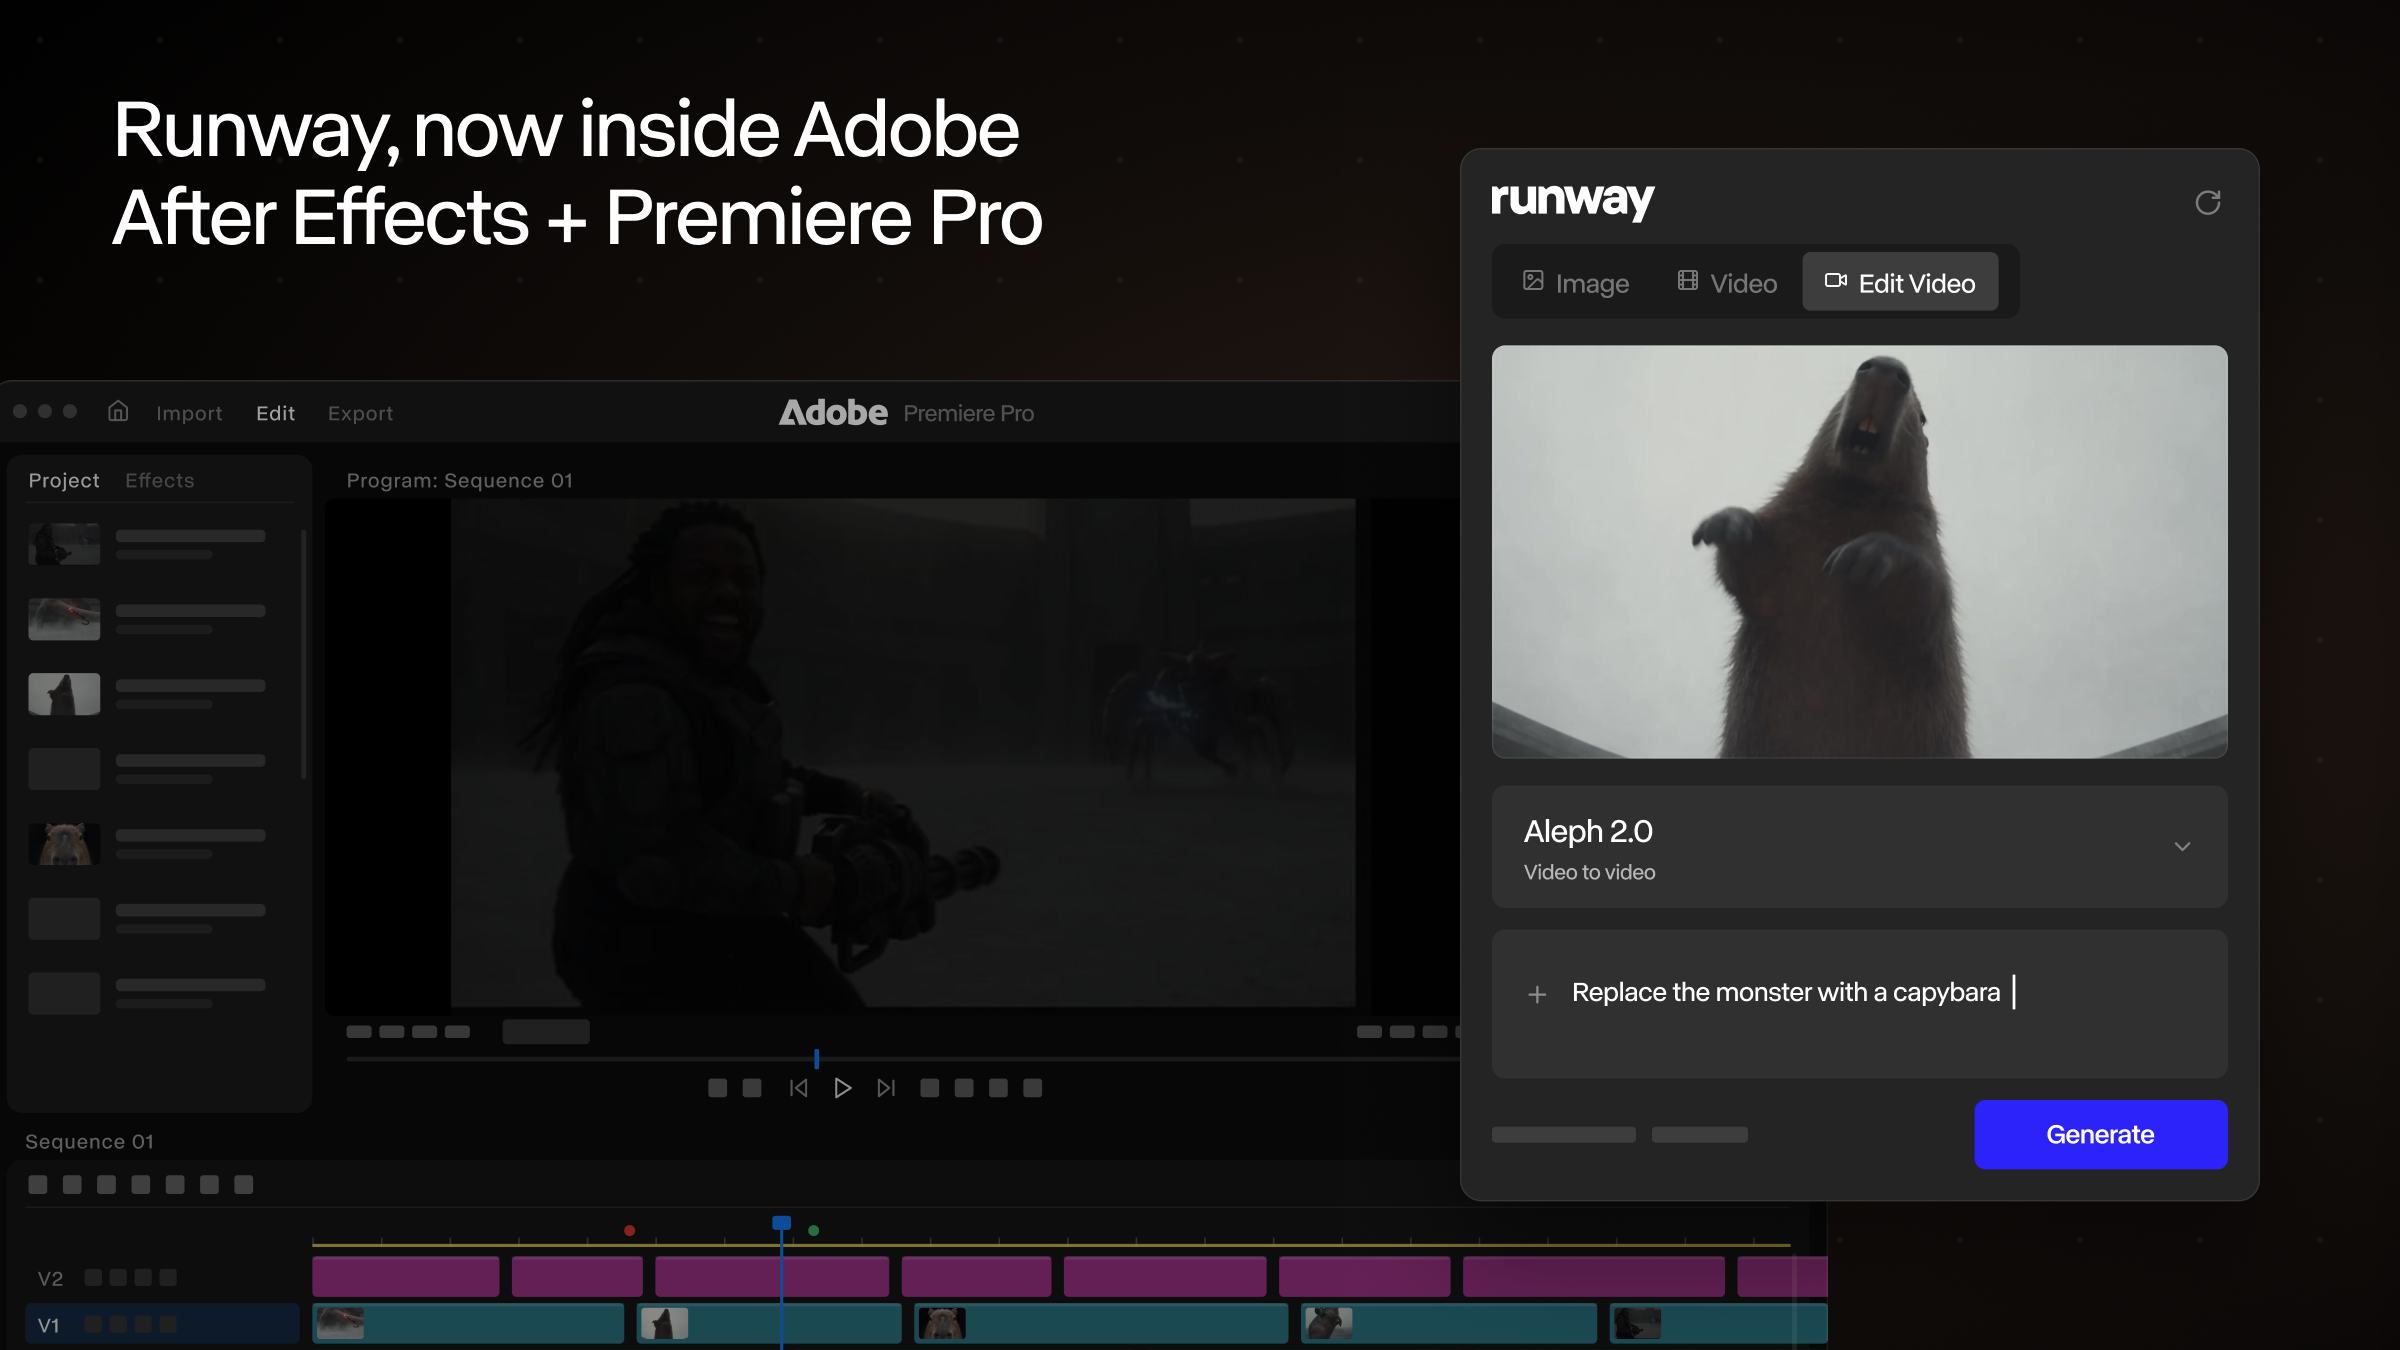
Runway 发布 Runway Plugins,面板可直接嵌入 Premiere Pro 和 After Effects,无需导出导入即可在时间线内生成图像和视频、重渲染片段并一键放置结果。
标题、出处和时间是判断一条消息是否值得继续读的第一道门槛。把这三件事看清楚,比先追情绪更省时间。