2026-11-05
Philipp Schmid 演示如何用 Gemini API CLI 配合编码 Agent 测试语音等多模态功能
Philipp Schmid 分享用 Gemini API CLI 配合编码 Agent 测试语音、音频等多模态功能的方法
Philipp Schmid 分享用 Gemini API CLI 配合编码 Agent 测试语音、音频等多模态功能的方法
Suno 宣布现在可以在 Suno 上用 MIDI 起始歌曲创作,详细介绍见其博客 https://suno.com/blog/MIDI-in-create。
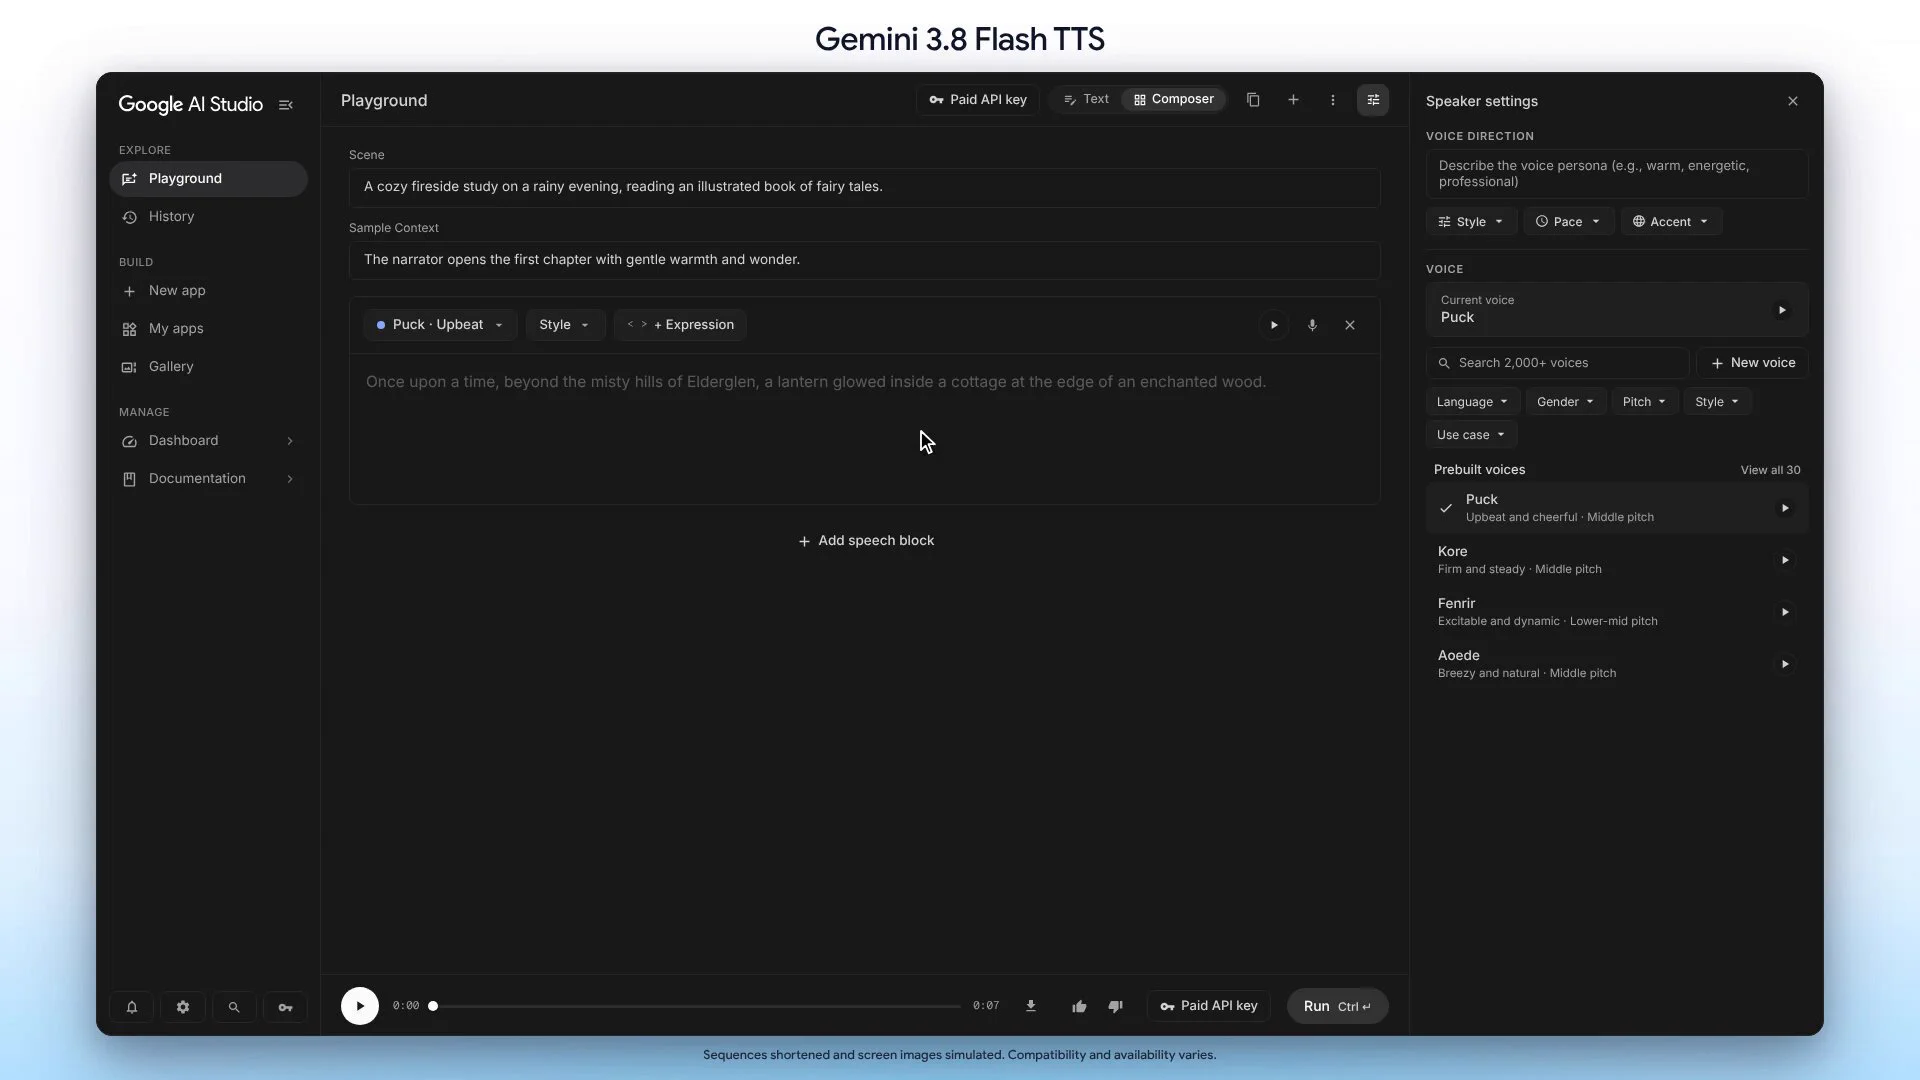
Google 宣布 Gemini 3.8 Flash TTS 的 Voice Remixing 功能已在 Google AI Studio 和 Gemini API 上线。用户可从 2000+ 预设声音库或自定义声音起步,用提示词微调音色、音高、语速和口音,例如加轻微美国南方口音或让它听起来像喷火龙。
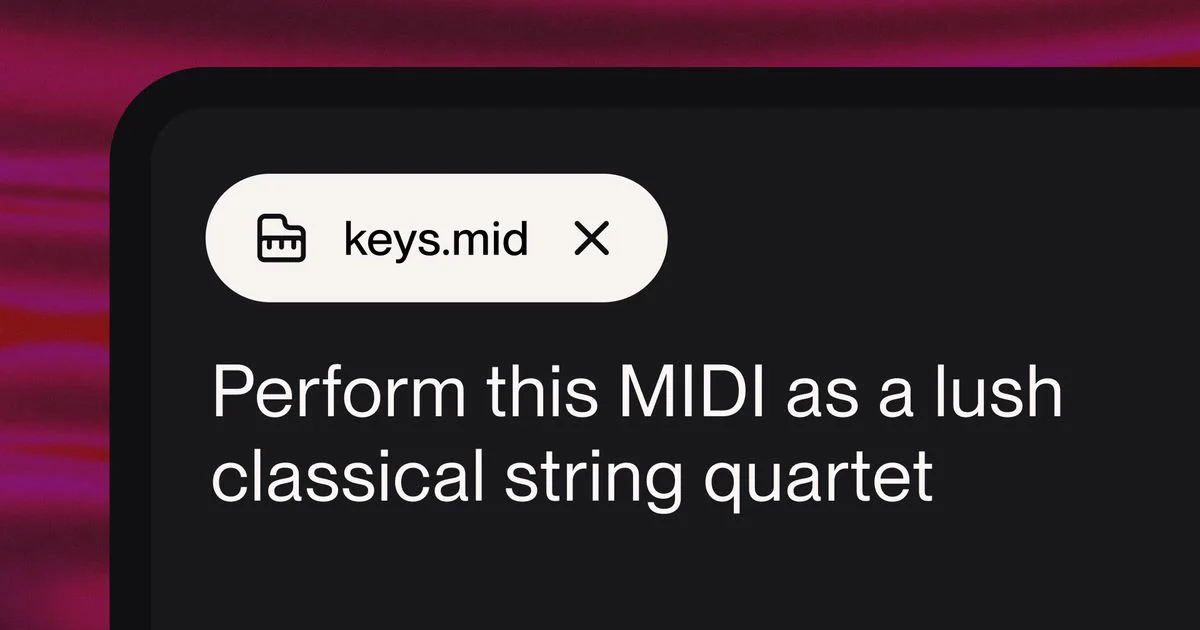
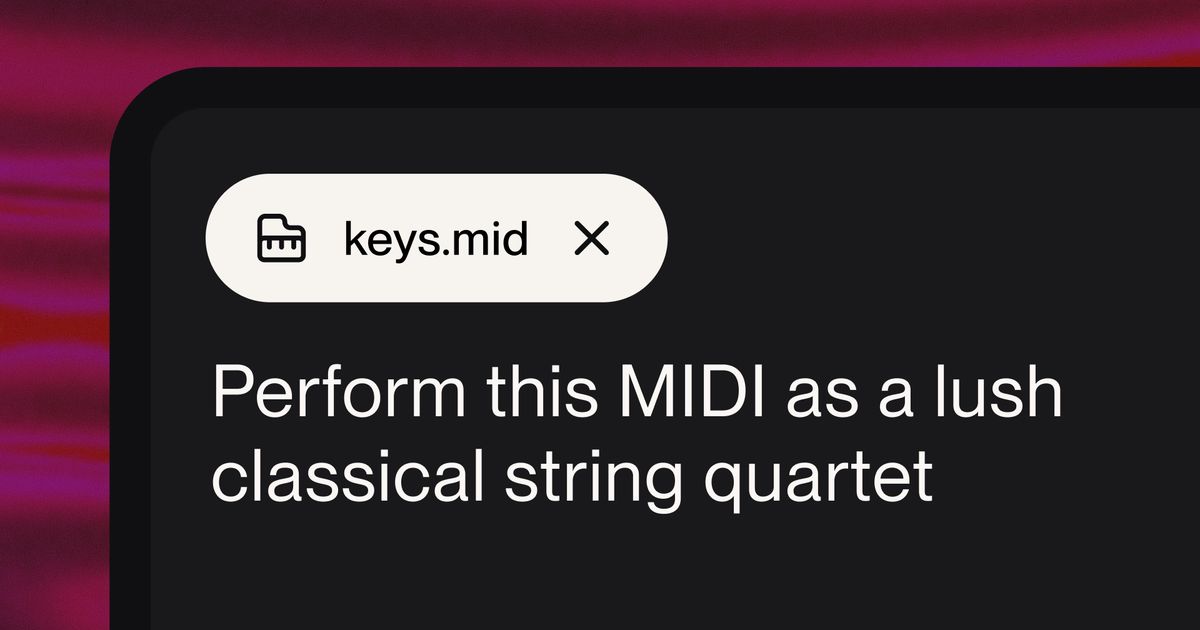
Suno 上线 MIDI 起手功能,用户可将 .mid 或 .midi 文件拖入 Create 页面或从 + 菜单选择 MIDI 开始创作。MIDI 只包含音符与节奏等数据,用户可用自然语言指示模型严格按原谱演奏、提取动机发展新想法或更换乐器编制
OpenAI 官方账号宣布 ChatGPT Voice 支持财务功能 Finances,用户可通过 Finances 安全连接账户后,用语音谈论消费、储蓄等财务问题。入口为 https://chatgpt.com/finances。
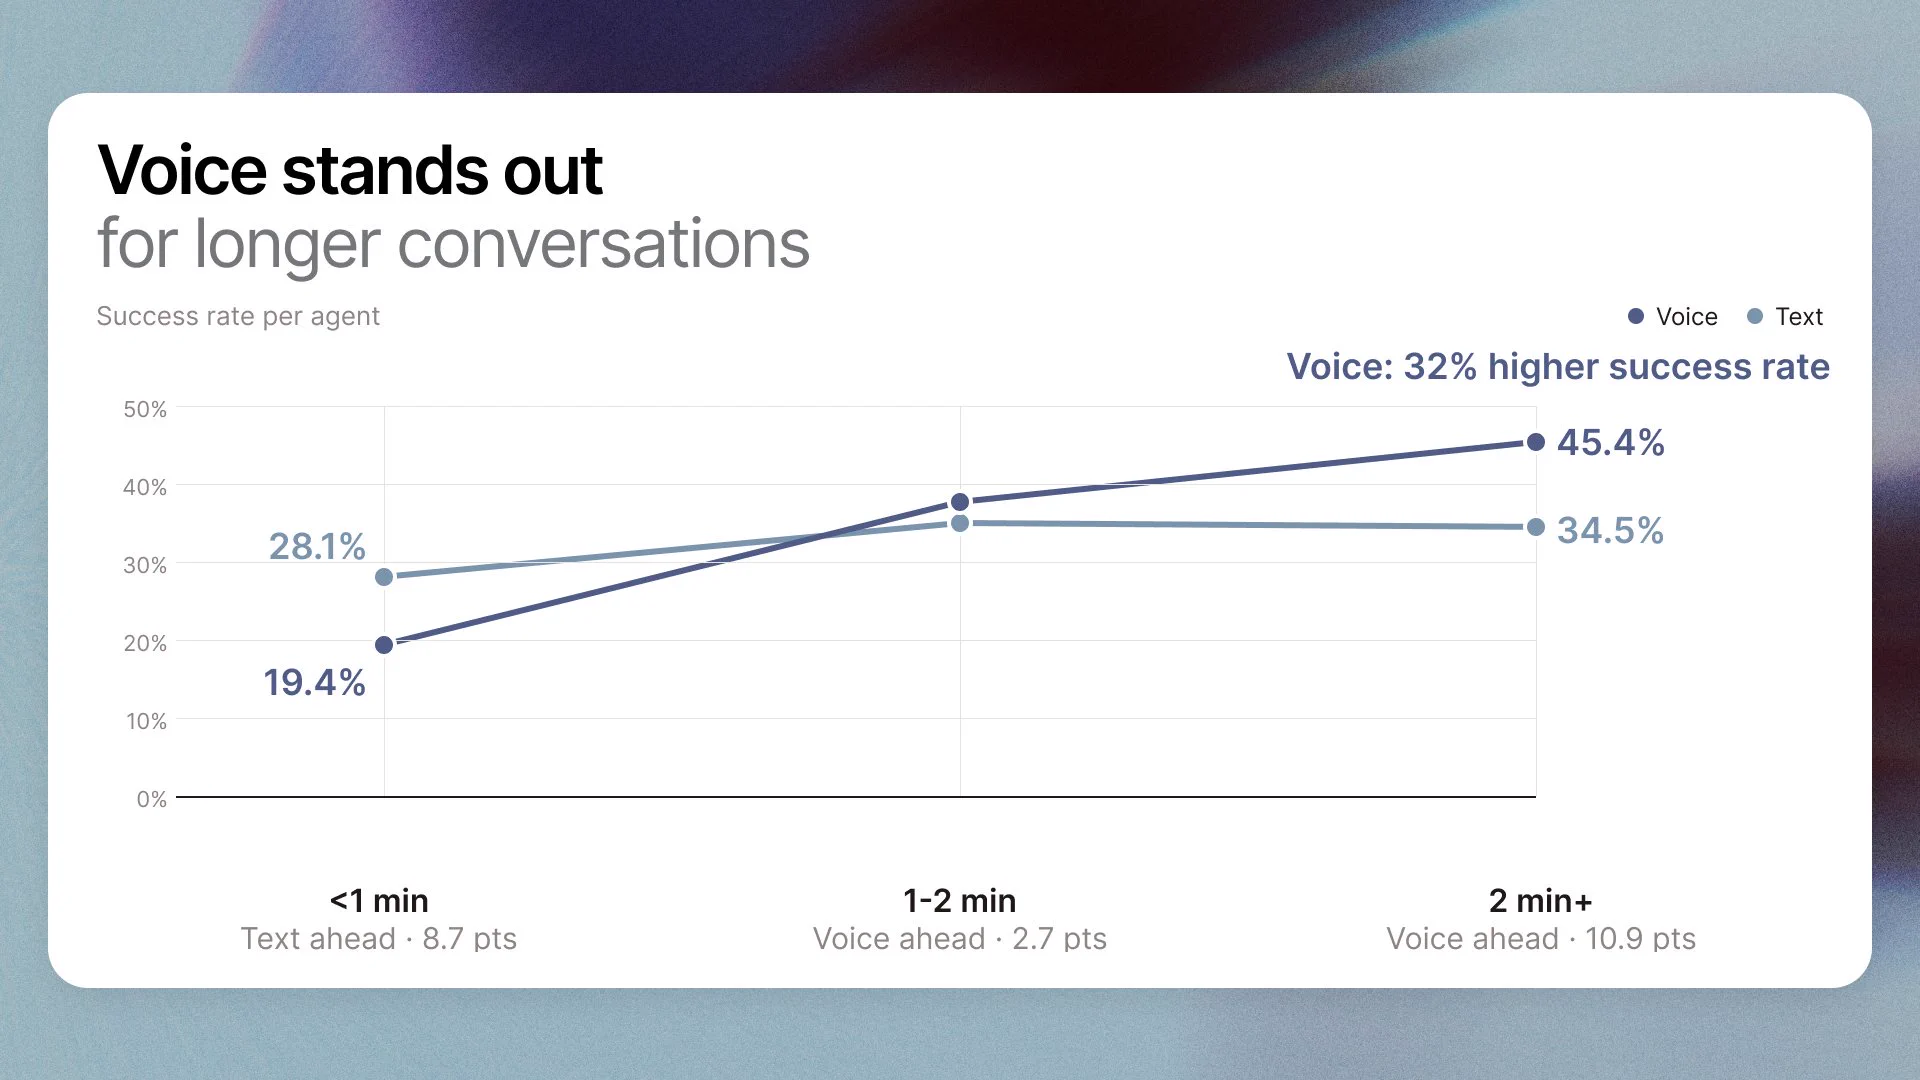
对话越长,语音智能体的成功率越高。 我们分析了 469 个在生产环境中同时运行语音和聊天的智能体,发现了一个有趣的规律。当对话变得复杂时,语音是解决问题最快的路径。 https://elevenlabs.io/blog/voice-wins-complex-stressful-conversations
Hume AI 推出 Hume Decision API,一款基于音频的模型,通过分析录音来回答关于说话者情绪和内容的问题,在初始测试中其与人类面板答案的一致率达 70.7%。
IT之家 11 月 1 日消息,据金融时报 FT 消息,Spotify 正在积极推进版权授权谈判,并努力说服音乐人拥抱新技术。Spotify 计划在 2027 年初推出一项由人工智能驱动的新服务,允许用户自行制作歌曲的混音与翻唱版本
10) 用我们音质最佳的音乐生成模型 Lyria 3.5,创作你迄今最出色的曲目。 轻松选择或描述你的曲风,设定曲目时长,并在人声或器乐风格之间选择。你还可以探索新模板来激发创意,从背景音乐到定制生日歌曲,应有尽有。
AI也能重新编曲和翻唱?Spotify计划推出付费音乐混音服务 · · Oct 30, 2026 Spotify计划于2027年 第一 季度推出AI音乐混音服务,允许付费订阅用户利用人工智能对现有歌曲进行重新编曲或翻唱,并考虑每月额外收取4至5美元。公司正争取在2027年2月格莱美奖颁奖典礼前后发布该服务,但具体上线时间和定价尚未最终确定
本文探讨 ElevenLabs 如何通过超越机械式 TTS、迈向语义感知的生成式音频,彻底改变合成语音,并提供即时声音克隆与自主配音能力。
用一条提示词描述场景,SFX v3 就能开始工作。 人群欢呼,球落下,然后人群发出嘘声。SFX v3 能更可靠地遵循多条指令,一步步把你描述的内容更多地融入音频中。
现在就试用 SFX v3,在 @ElevenCreative 内的所有创作场景均可用:flows、音效标签页、studio 和音乐编辑器。 ElevenAPI 和 ElevenLabs 移动应用同样可用。 https://elevenlabs.io/blog/soundeffectsv3
大场面很少只靠一个声音,所以我们打造了 SFX v3,让它能处理前所未有的更多内容。 我们最新的模型让你只需一段文本提示词,就能创建更丰富、更精确的音效,音乐和人声也有所提升。 现已在 @ElevenCreative 和 ElevenAPI 中上线。
作者分享了如何利用即梦 AI 短剧工作室、Suno 和 Claude 从零构建一个具有互动剧情的“马尔福女友”桌面应用。
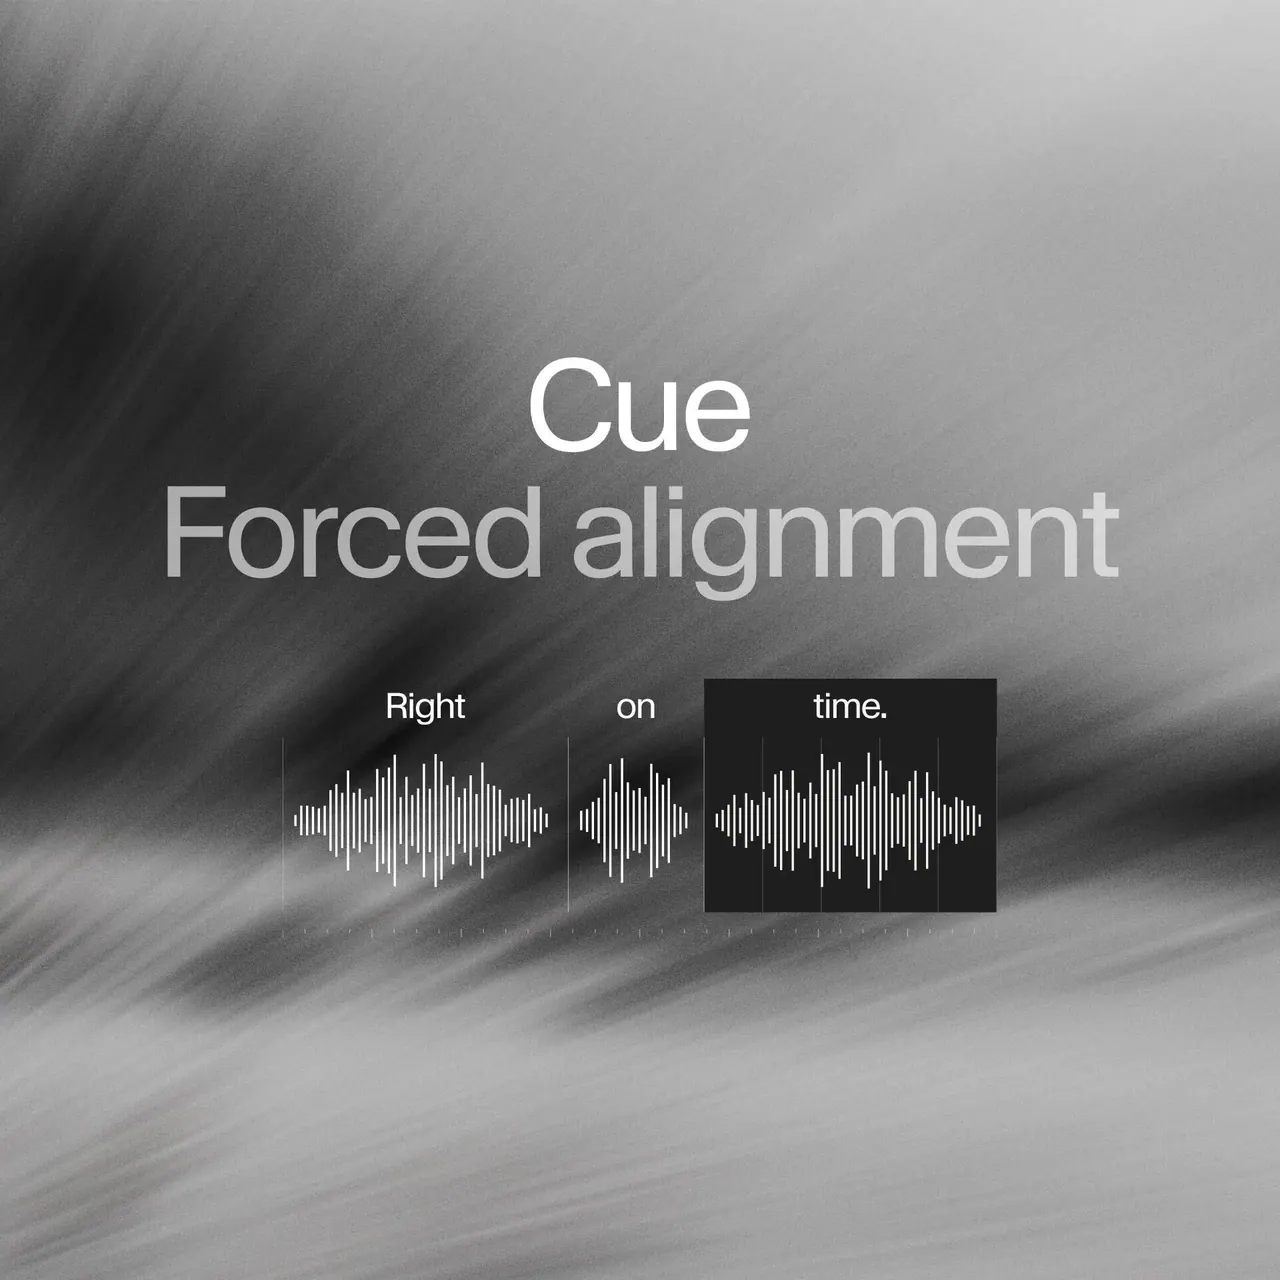
ElevenLabs 研究团队发布强制对齐模型 Cue,能将每个字符精确放到音频时间轴上,精度高于其测试过的所有开源对齐器,覆盖基准测试全部 29 种语言
IT之家 10 月 29 日消息,苹果公司今日推出首款触控屏 MacBook Pro,提供 14 英寸和 16 英寸两种型号。值得注意的是,这款笔记本支持灵动岛,可将实时活动、聚焦搜索和 Siri AI 整合到屏幕上方交互,这也是苹果首次为 Mac 电脑引入灵动岛
在 Suno Studio 里,从一个随机采样到一段完整节拍 🔥 你接下来会加什么?
ElevenLabs 与西班牙主要 ALS 协会 AsociacionELA 合作,向西班牙全国的 ALS 患者免费开放其声音重建技术。工程师兼教授 Aníbal 因 ALS 逐渐失声,用该技术复刻了自己的声音,得以继续教学。
IT之家 10 月 28 日消息,豆包公关负责人刘星今日发文称,“横店与字节合作,将 15 万名群演的肖像和声音喂给字节大模型”的传言严重失实。 他表示,横店影视 AI 服务平台项目,其实是希望建设一套公共数字基础设施,把影视基地实景等资产做成高质量数据集,帮助剧组更高效地选景、筹备和拍摄,也降低中小影视企业使用 AI 的门槛,让更多创作者有条件把作品做好
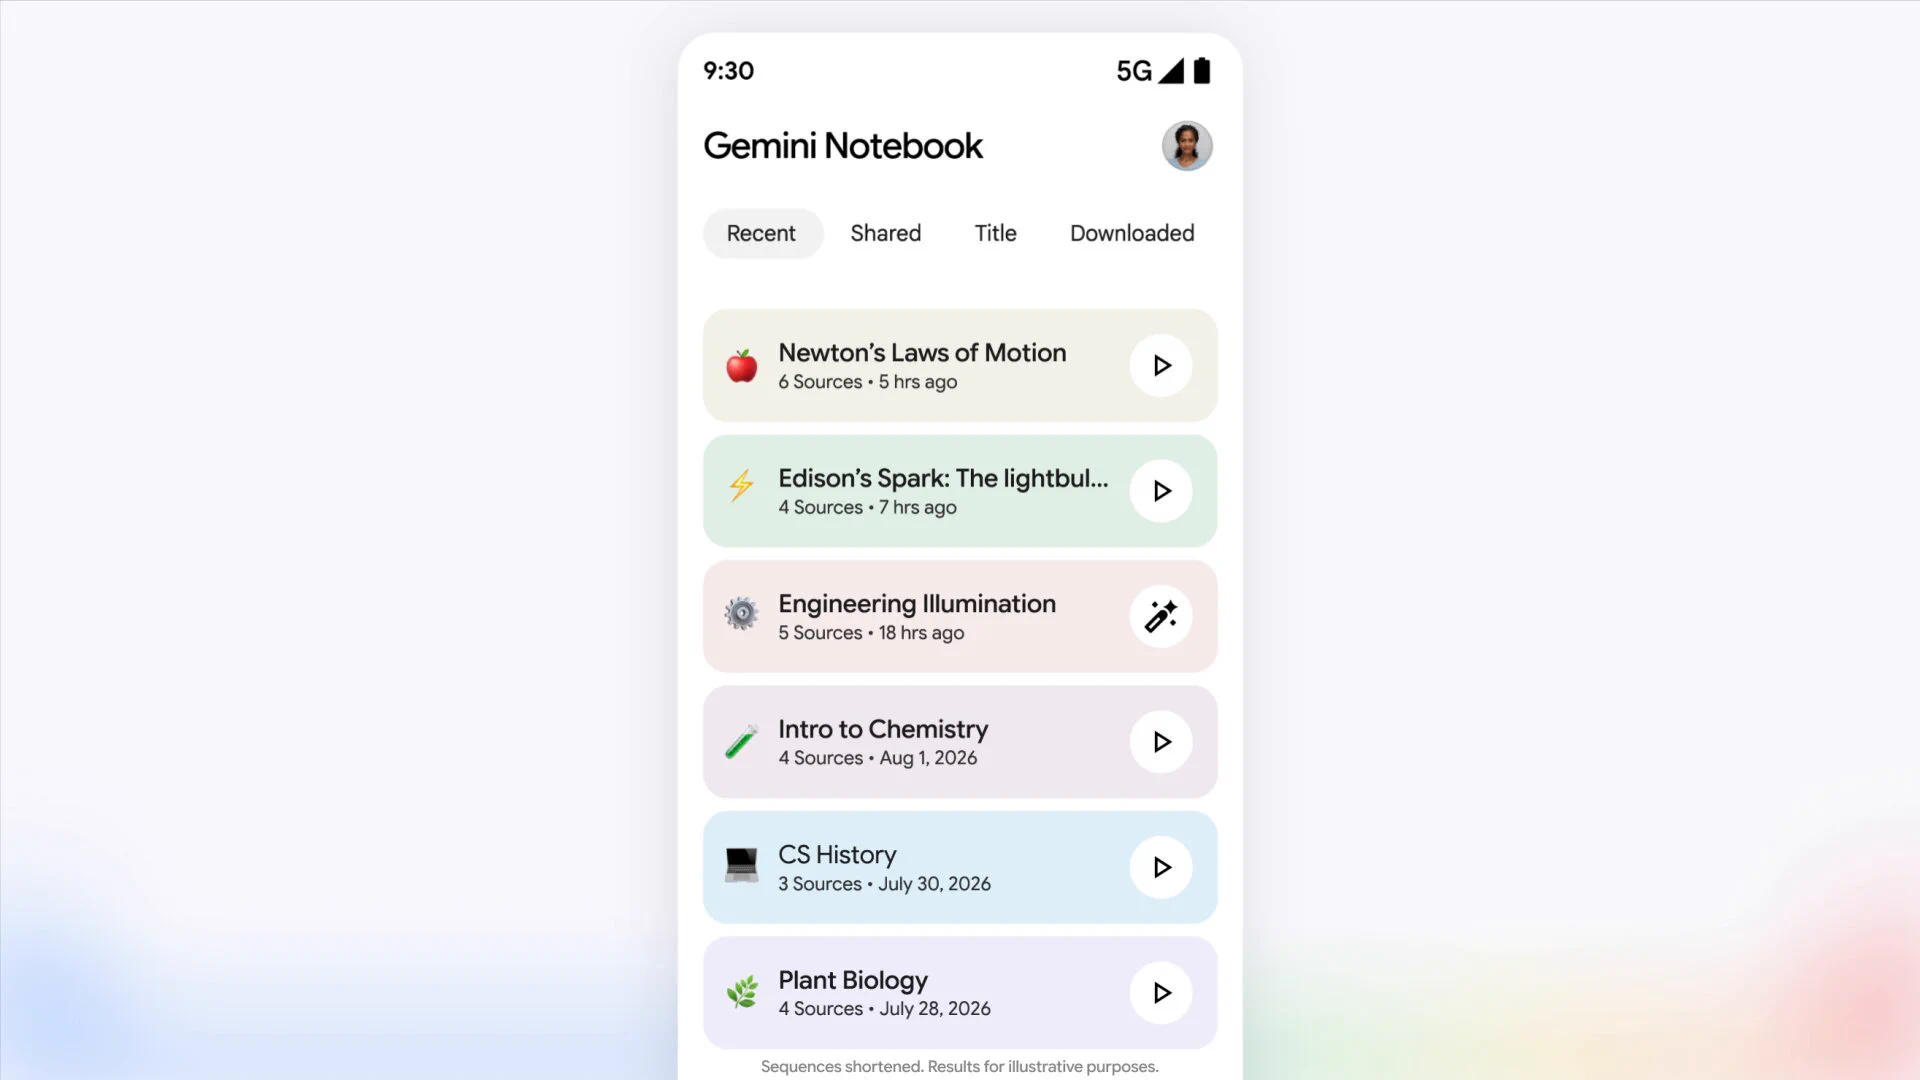
GOOGLE 🔥:Gemini Notebook 移动端现在最多可录制 1 小时的实时音频! > 录制的音频之后可作为 Notebook 的来源使用。 该功能似乎在逐步推送中。 Live Notebook 👀
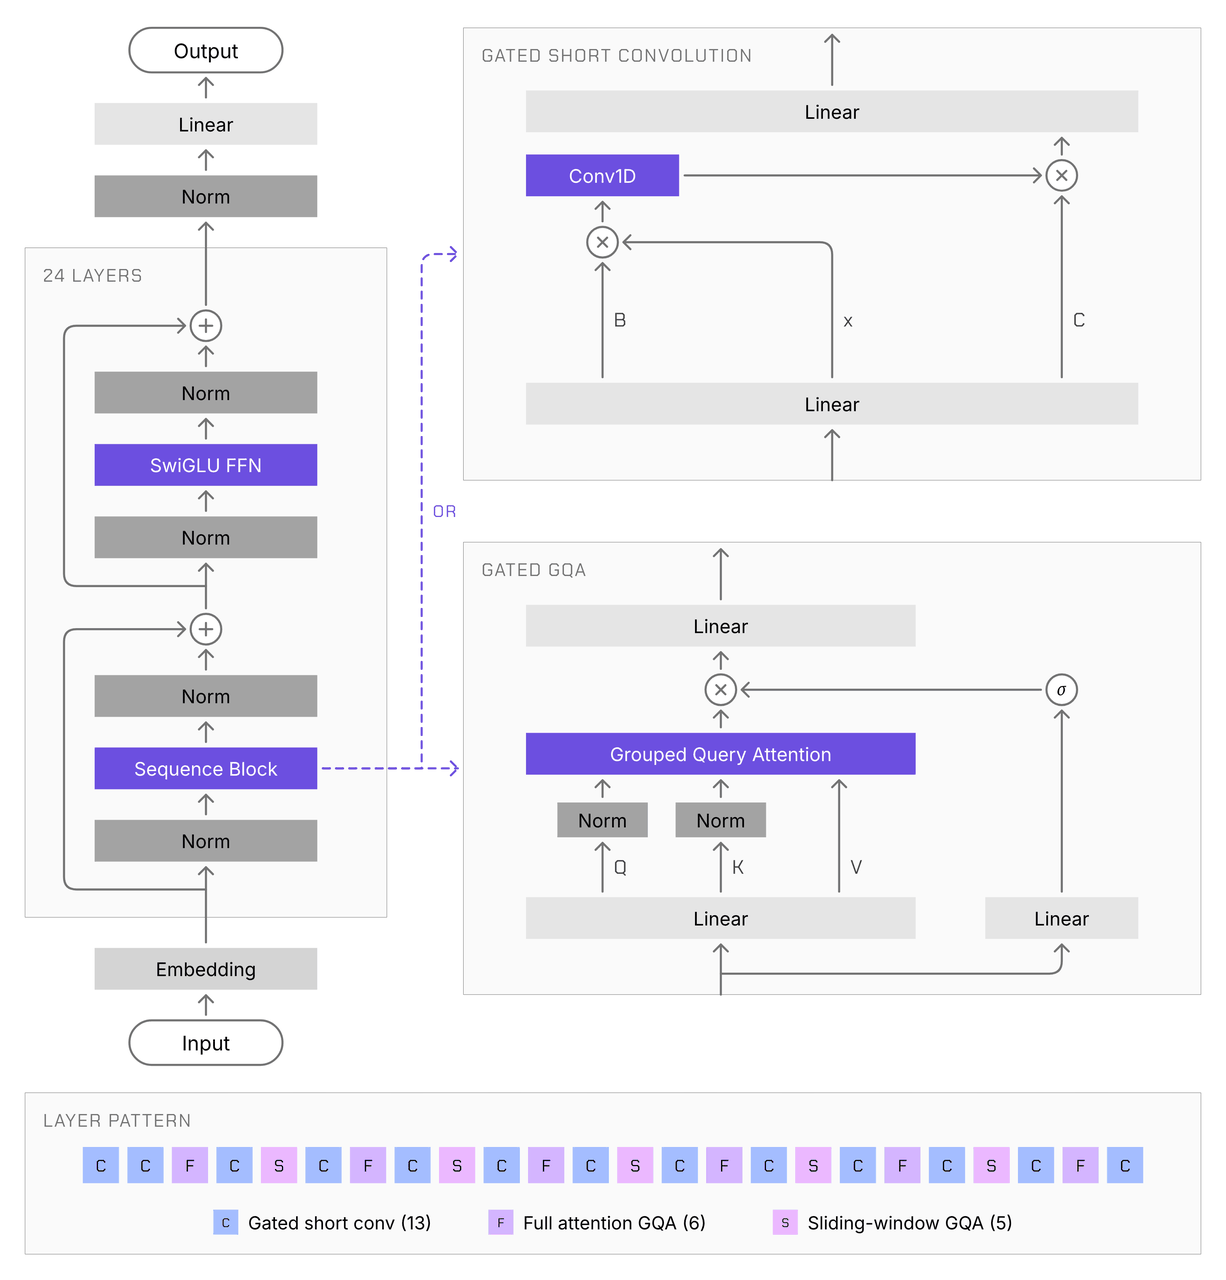
Liquid AI 发布 LFM3 系列共 6 个开源权重 2B 级模型,基于同一 tri-hybrid 骨干覆盖文本、视觉、音频、omni 和决策任务。
每个语音智能体都得在电视声、狗叫声或大奖赛看台的嘈杂中听清客户说话。 我们想试试更吵的环境,于是借用了 @audif1_ 的风洞。 抱歉吵到你了,@HulkHulkenberg。
Liquid AI 在 Hugging Face 发布 LFM3 系列,以 LFM3-1.7B-Base 为共享底座,提供文本、视觉、音频、全模态和决策共六个 2B 级模型,均开放权重。
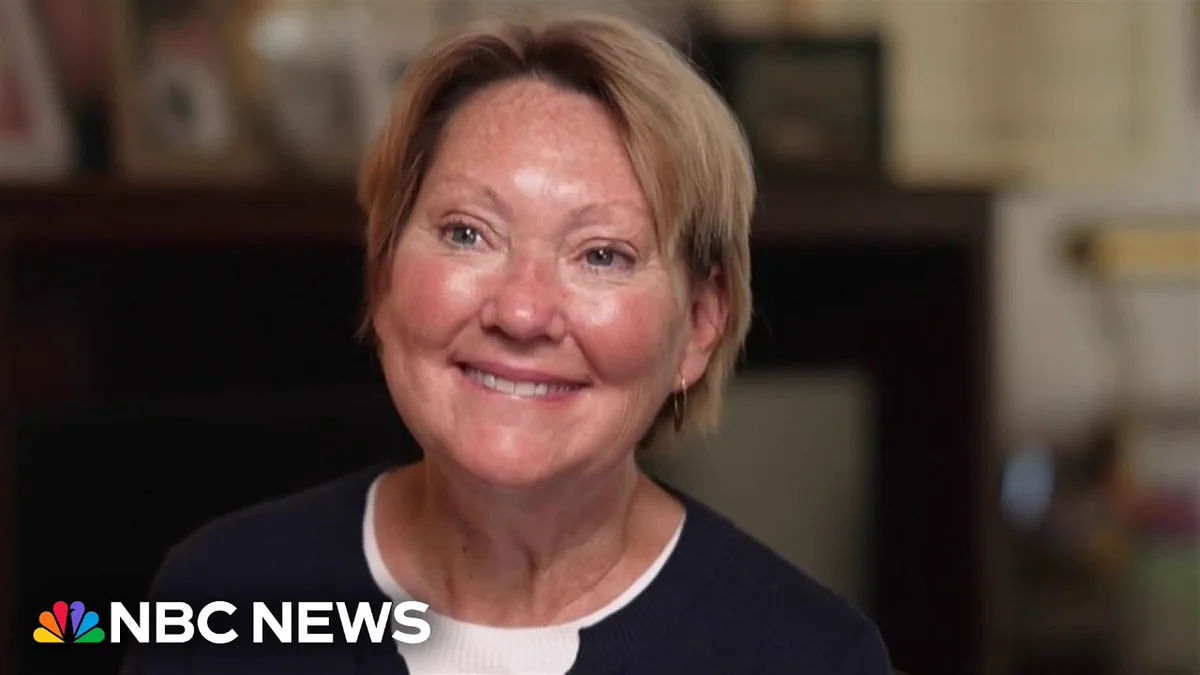
ElevenLabs 介绍 ALS 患者 Monica 的案例:团队从一段旧家庭录像中复原了她的声音,她在女儿婚礼上用原声致辞,并以此与家人交流。NBC News 对 Monica 进行了采访报道。原文称该技术已帮助超过 11000 名因伤病失去声音的人恢复语音,并承诺帮助全球 100 万语音障碍者。
Liquid AI 发布新一代 LFM3 模型家族,以 LFM3-1.7B-Base 为共享骨干,首批开放六个 2B 级模型(文本、视觉、音频、omni 及两个决策模型)的开放权重,可在 Hugging Face、Playground 和 Liquid AI API 获取。
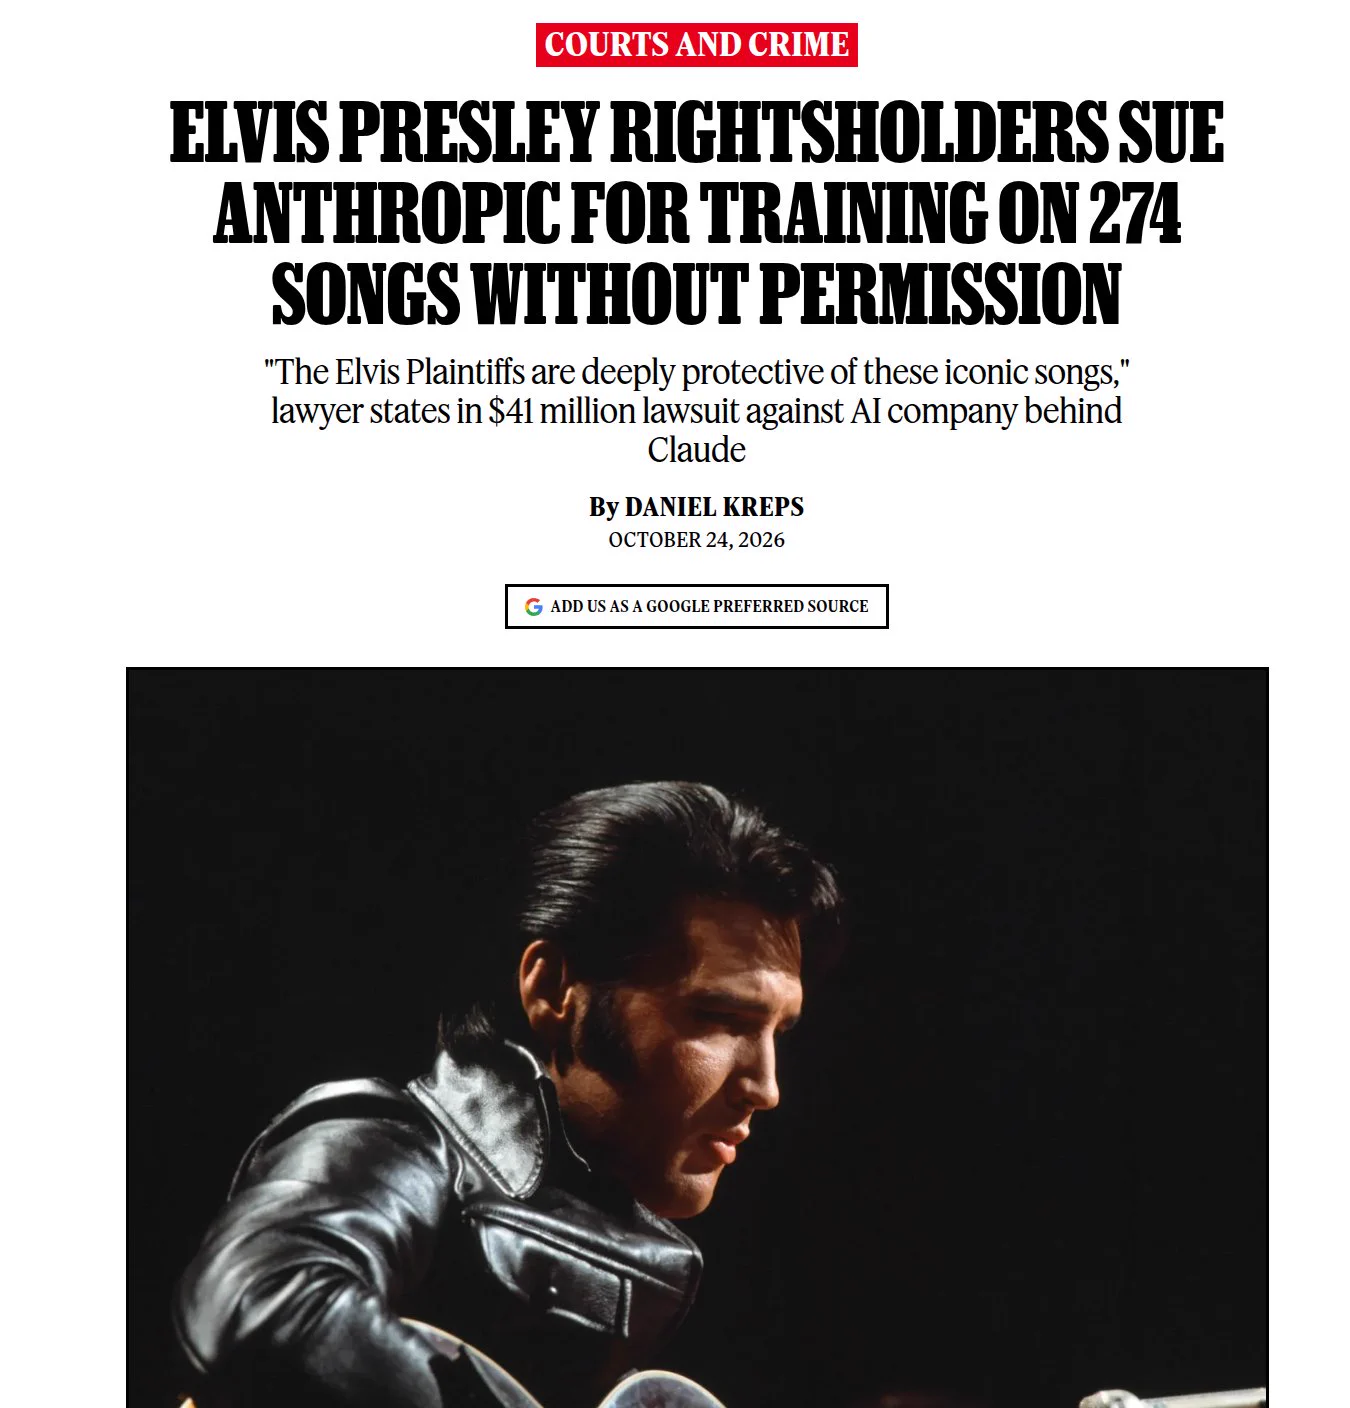
IT之家 10 月 26 日消息,猫王 · 埃尔维斯 · 普雷斯利(Elvis Presley)音乐曲库的持有方正在起诉人工智能企业 Anthropic,指控该公司未经许可使用普雷斯利的歌曲训练 AI 模型
Elvis Presley 音乐版权方 Authentic Brands Group 联合多家出版商对 Anthropic 提起联邦诉讼,指控 Claude 在 274 首歌曲上训练,按每件 15 万美元的法定赔偿上限索赔约 4100 万美元。
AI巨头遭猫王版权方索赔 4100 万美元:当传奇音乐遇上大模型侵权风暴 · · Oct 26, 2026 近日,猫王埃尔维斯·普雷斯利(Elvis Presley)音乐曲库的持有方正宗品牌集团(Authentic Brands Group)正式向人工智能企业 Anthropic 提起诉讼
程序员 Daniel Murrell 开发了 OnKey,一个利用 AI 分析原唱旋律并实时反馈用户音准的软件,旨在帮助用户自己学会唱歌,而不是依赖 AI 替唱。